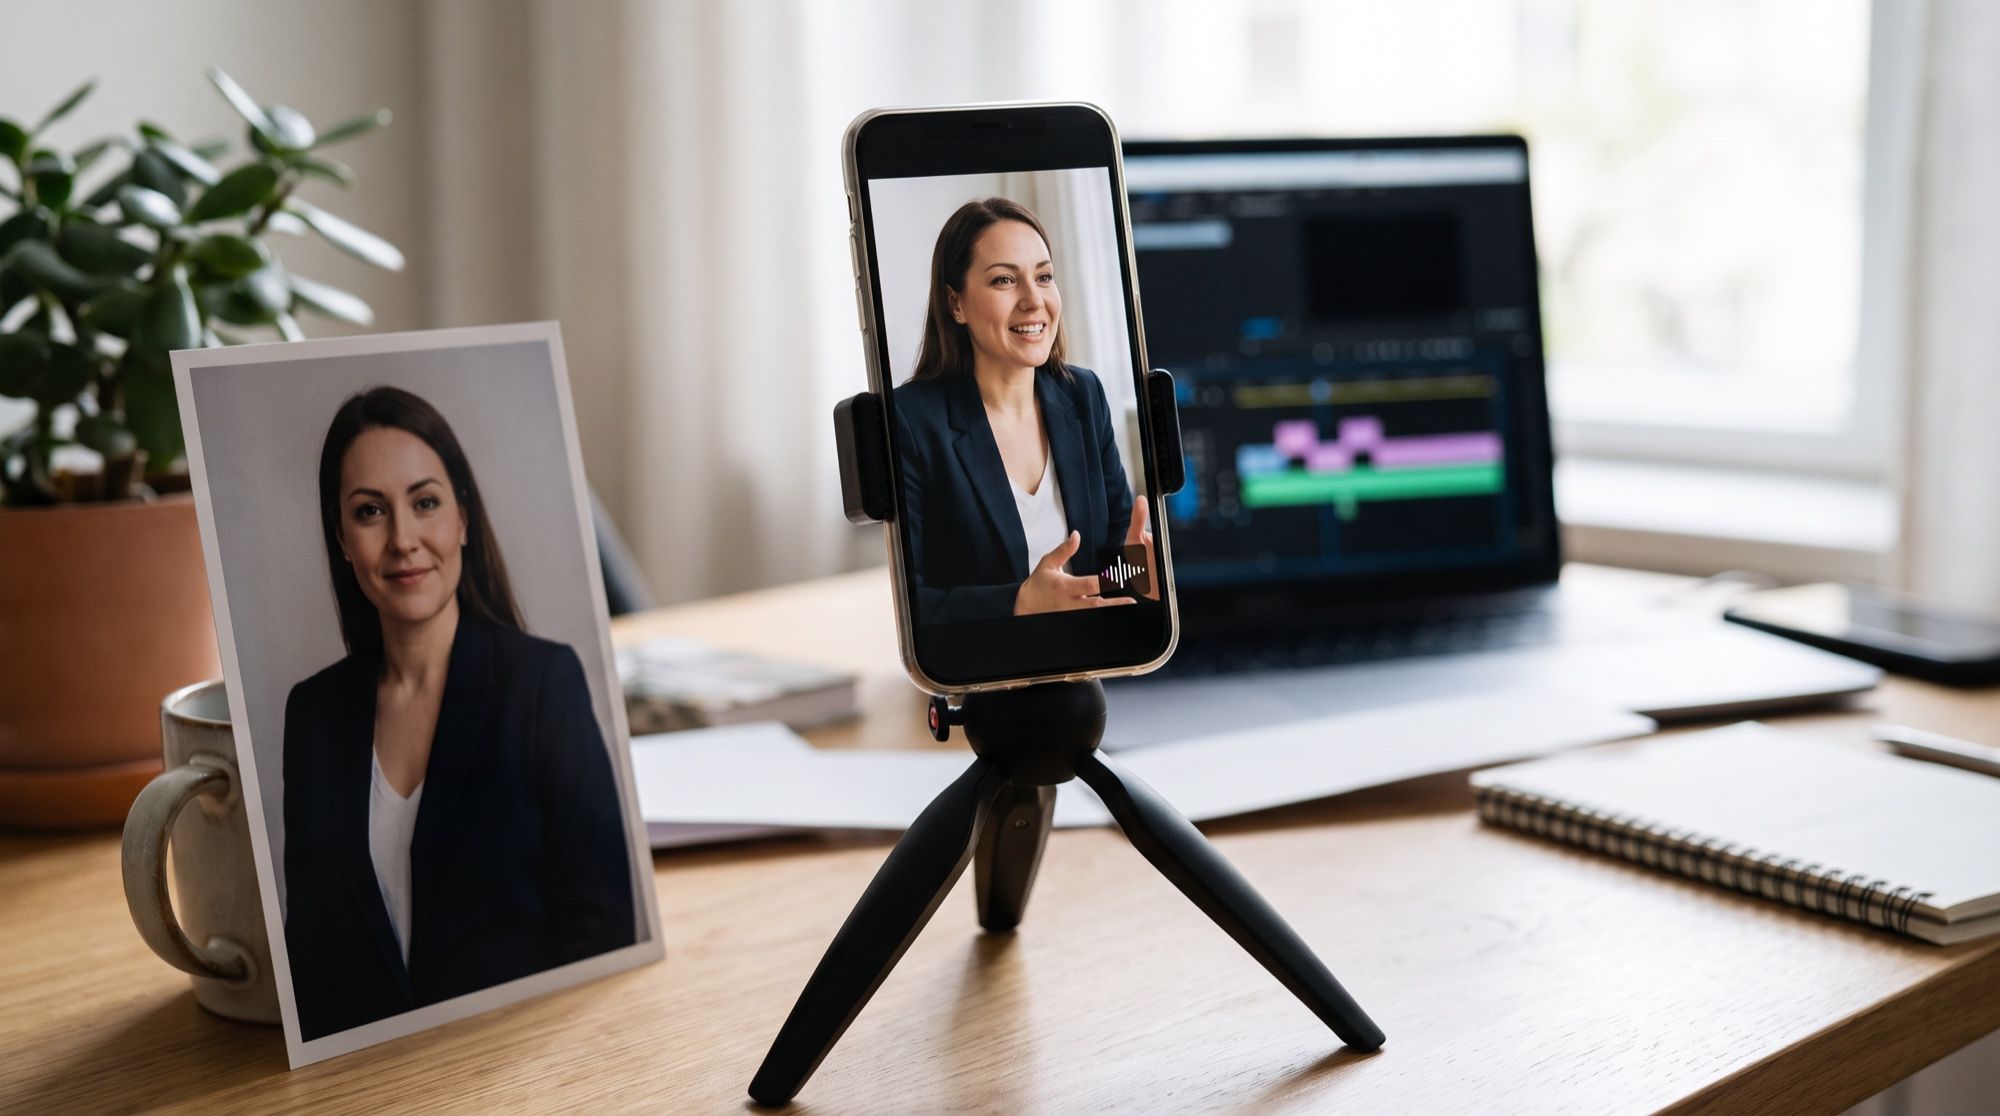
会说话的照片,是一段视频:肖像里的人看着镜头说出指定的文字,嘴唇随字词开合,眼睛眨动,头部轻微晃动。以前这要用两个工具:一个让脸动起来,一个给文字配音。2026 年的视频模型一次生成就能同时完成。我们用同一张肖像和同一句俄语台词测试了其中三款。
1. 模型怎样让照片说话
照片成为视频的第一帧。模型在此基础上生成后续画面:口型、表情、眨眼和细微的转头。提示词里引号中的台词会变成语音——模型生成声音,并让口型与之同步。Veo 3.1、Kling 3.0 和 Seedance 2.5 都是这样工作的:三款模型的声音都和画面一起生成。
还有第二种做法:上传现成的录音。Seedance 2.5 最多接受 10 个音频文件作为参考,所以语音可以是你自己的声音,或者提前录好的声音。
2. 让照片说话的 4 个步骤
- 准备肖像。 脸要大、正对镜头,嘴巴闭合,光线均匀。画幅按平台选:快拍和 Reels 用 9:16,YouTube 和演示文稿用 16:9。
- 写台词。 8 秒最多 12–15 个词。标点决定停顿,所以在人需要换气的地方加句号和逗号。
- 描述声音和动作。 语言、音色、语气和表情:“用温暖的女声说话,会眨眼,结尾微笑”。
- 排除多余元素。 写上“镜头固定,无音乐,无字幕,画面无文字”——否则模型可能加背景音乐或字幕。
3. 什么样的照片适合做会说话的头像
我们用了 头像提示词 指南里那位女生的肖像,在 Nano Banana Pro 里把它做成一张竖版“博主坐在桌前”的画面。
画面里要注意的几点:
- 嘴巴闭合。 模型会在第一个音节时自己张嘴;照片里嘴是张开的,视频开头会出现跳变。
- 脸在画面上半部分。 竖屏视频这样能给平台界面留出位置。
- 脸部周围不要有遮挡。 手、麦克风、搭在嘴唇上的头发都会影响口型同步。
- 用自己的照片,或取得对方同意。 未经许可用别人的脸做说话视频,就是深度伪造,而不是头像。
4. 测试:同一句台词交给三款模型
同一帧画面,同一个提示词,8 秒,9:16。台词是俄语:«Привет! Это обычное фото, а теперь оно говорит. Сделать так можно за минуту.»(“你好!这是一张普通照片,现在它会说话了。一分钟就能做到。”)
The woman looks straight into the camera and speaks in Russian in a warm,
natural female voice: «Привет! Это обычное фото, а теперь оно говорит.
Сделать так можно за минуту.» Accurate lip sync, natural blinking, small
head nods and a soft smile at the end, static camera, quiet room
ambience, no music, no subtitles, no text on screen
我们逐帧并按音轨对比了这几段视频:
| Veo 3.1 | Kling 3.0 | Seedance 2.5 | |
|---|---|---|---|
| 脸部和特征 | 保留 | 保留 | 保留 |
| 视频开头 | 第一帧就开口 | 0.5 秒静音,嘴巴闭合 | 0.6 秒静音,嘴巴闭合 |
| 语音中的停顿 | 没有静音空档 | 中间一次停顿 | 四个短句,停顿 0.4–0.9 秒 |
| 表情 | 最丰富 | 平稳,主播式 | 口型克制 |
| 视频结尾 | 几乎说到最后 | 2 秒静音加微笑 | 0.9 秒静音 |
| 单次生成时长 | 最长 8 秒 | 最长 15 秒 | 最长 30 秒 |
测试结论:三款模型都保留了脸型、雀斑和耳环,也都念出了俄语台词。Veo 3.1 看起来最生动,适合情绪化的社交媒体短片。Kling 3.0 给出平稳安静的视频,结尾有停顿,方便把几句话接在一起。Seedance 2.5 最严格地跟随标点,也是三款里唯一能接受你自己录音的模型。发布前请亲耳听一遍具体台词的发音:Google 没有公布 Veo 3.1 能用哪些语言配音。
5. 怎样用自己的声音给照片配音
如果声音必须是你自己的,就不用生成语音——可以直接交给模型。
- 在安静的房间用手机录下台词,5–15 秒。
- 在 Seedance 2.5 里把肖像作为首帧上传,把音频文件作为参考上传。
- 在提示词里说明语音来自这段音频,模型只负责口型、表情和眨眼。
同样的方法也适合播音员配音或歌曲:模型会让口型对上任何上传的音轨。
6. 会说话的卡通头像
会说话的不只有照片,绘制的角色也可以。我们用了提示词指南里的 3D 头像,给 Kling 3.0 一句简短的俄语台词:«Всем привет! Я — ваш новый аватар.»(“大家好!我是你们的新头像。”)
卡通角色的容错更高:嘴唇本来就是风格化的,细小的同步误差不容易被看出来。但还是要检查整个画面——我们的视频边缘出现了一只提示词里没有的手。头像本身怎么做,见指南 AI 头像生成。
7. 会说话的照片能用来做什么
- 社交媒体和快拍。 简短问候、预告、回复粉丝,都不用拍摄。
- 教学和演示。 由一个主持角色讲解课程步骤或幻灯片。
- 广告和商品卡片。 拿着商品的人用一句话说出主要卖点。
- 博客头像。 每段视频都是同一个角色——不需要相机和灯光。
如果只想让照片动起来、不需要说话——微笑、眨眼、转头——可以看指南 照片变视频。
8. 免费让照片说话:现实情况
带声音的视频是最贵的生成类型:模型按视频的每一秒计费。达到 Veo 3.1 质量的完全免费服务并不存在。AI2Face 注册后会给初始积分,每段视频的费用在生成前就会显示。想少花一点,先用 4–5 秒的视频调好台词,再做最终版本。
9. 限制与伦理
- 时长。 单次生成:Veo 3.1 最长 8 秒,Kling 3.0 最长 15 秒,Seedance 2.5 最长 30 秒。长段讲话请拆成多段视频。
- 发音。 模型有时会读错重音或生僻词——发布前每段都要听。难读的词按读音来写。
- 多余细节。 模型可能加上手、物体或镜头运动——在提示词里写明不应出现什么。
- 他人的脸。 不要用未同意的人做说话视频,也不要让真实人物说出他们从未说过的话。
- 亲人的照片。 让家庭老照片动起来很感人,但决定权在家人手里;已故之人的说话视频可能会伤害亲属。
总结
2026 年,让照片说话只需一次生成:肖像作首帧,台词放进引号,再描述声音——模型会自己配音并对上口型。在我们的测试里,三款模型都念出了俄语台词,并保住了人物的脸。Veo 3.1 适合 8 秒以内生动、有情绪的短片,Kling 3.0 适合平稳的讲述和拼接多句台词,Seedance 2.5 适合最长 30 秒的视频和用自己的录音配音。发布前请听完每段视频并检查整个画面。在 AI2Face,三款模型都在同一个生成器里,每段视频的费用在生成前就会显示。
常见问题
怎么让照片开口说话?
把肖像作为视频的首帧上传,在提示词里用引号写出台词,并注明语言和声音:“用温暖的女声说:「……」”。Veo 3.1、Kling 3.0 和 Seedance 2.5 一次生成就能配音并对上口型。
哪款模型能让照片说英语以外的语言?
在我们的测试里,Veo 3.1、Kling 3.0 和 Seedance 2.5 三款都念出了一句俄语台词。表情最丰富的是 Veo 3.1,句间停顿最清楚的是 Seedance 2.5,最平稳、像主播口播的是 Kling 3.0。
能用自己的声音给照片配音吗?
能。Seedance 2.5 最多接受 10 个音频文件作为参考——上传一段自己的录音,并在提示词里说明语音来自这段音频。不提供音频时,模型会按描述自己生成声音。
能免费让照片说话吗?
部分可以。在 AI2Face 注册后会获得初始积分。带声音的视频比图片贵,所以先做 4–5 秒的短片。费用在生成前就会显示。
说话视频最长能有多长?
单次生成中,Veo 3.1 最长 8 秒,Kling 3.0 最长 15 秒,Seedance 2.5 最长 30 秒。8 秒大约能放下一句 12–15 个词的话;长文本请拆成几段视频。
资料来源
3
- https://ai.google.dev/gemini-api/docs/veo
- https://kling.ai/quickstart/klingai-video-3-omni-model-user-guide
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5