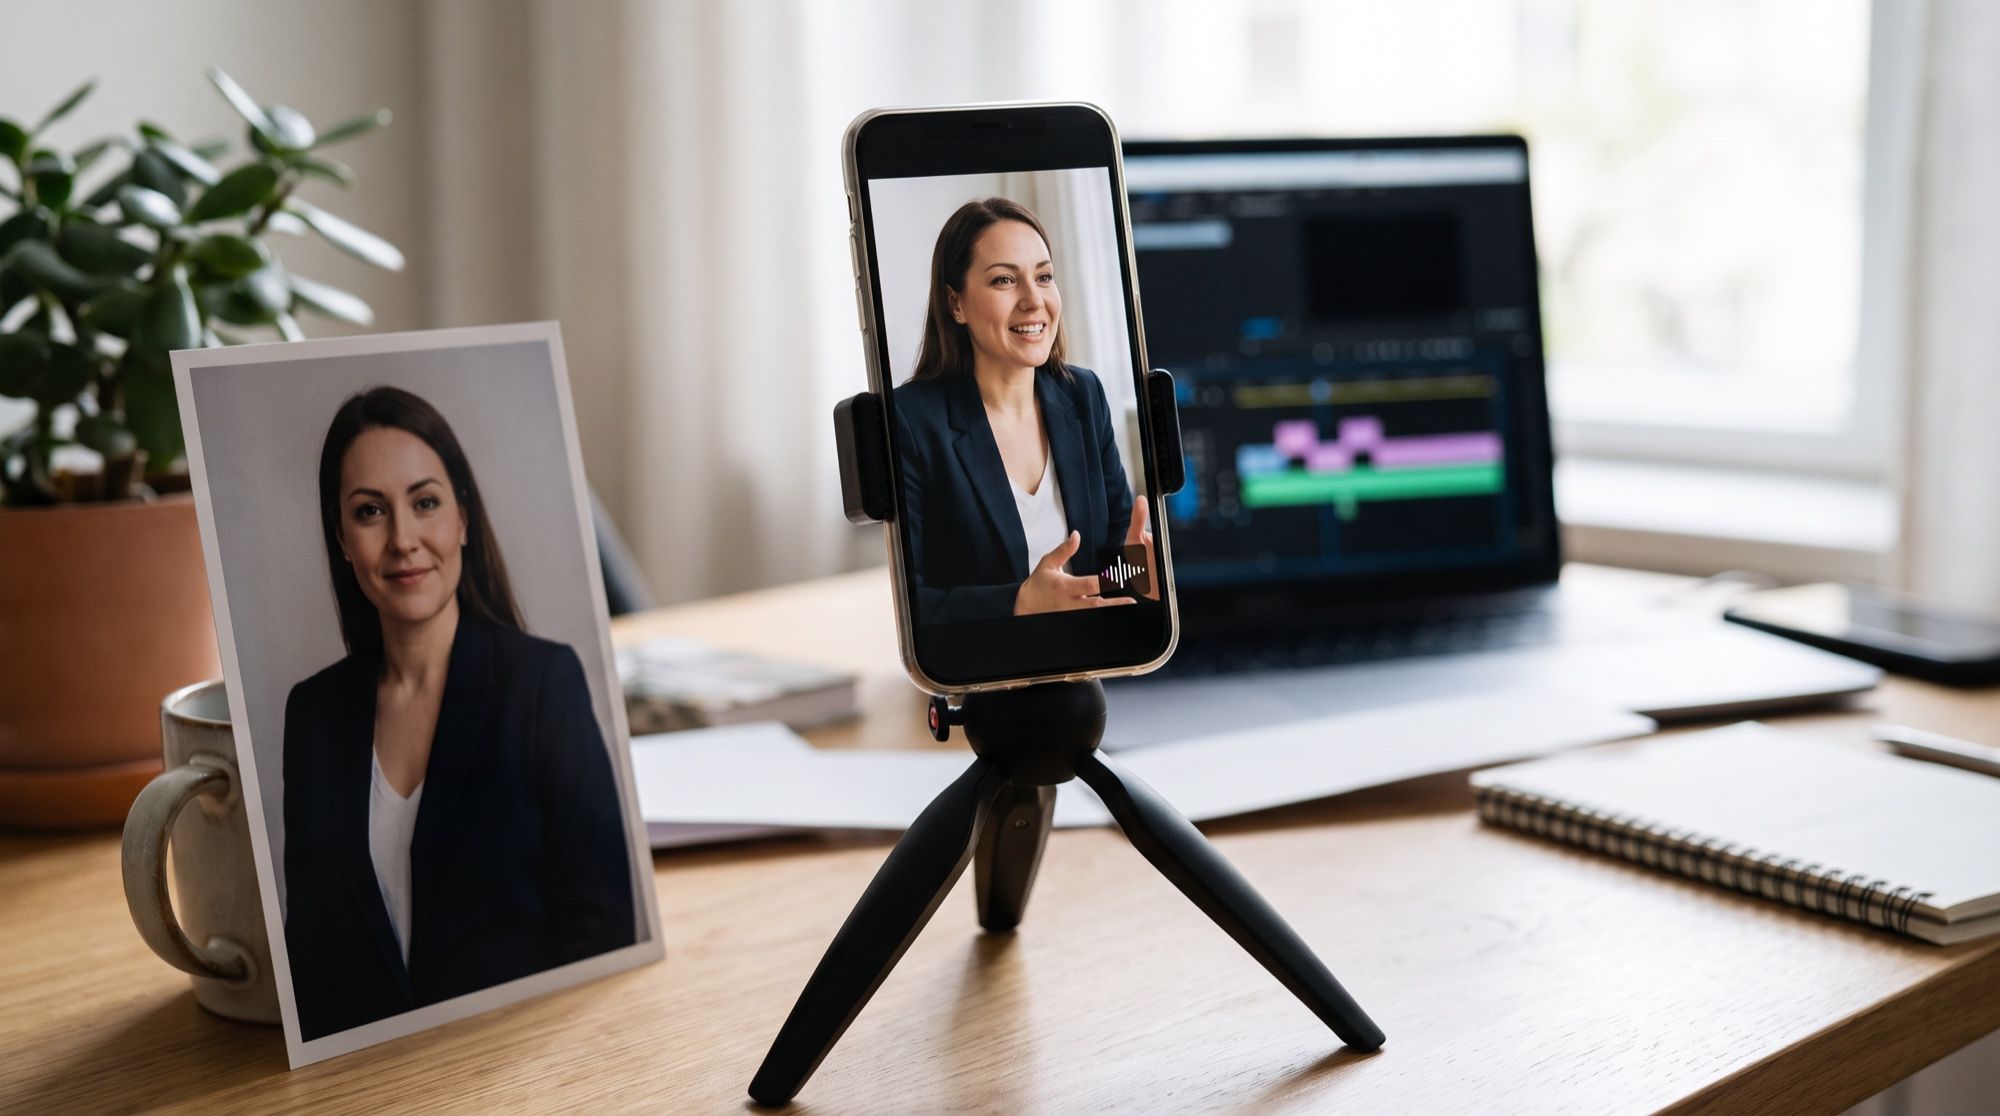
Une photo qui parle est une vidéo où la personne d’un portrait regarde l’objectif et prononce un texte : les lèvres suivent les mots, les yeux clignent, la tête bouge légèrement. Auparavant, il fallait deux outils : l’un pour animer le visage, l’autre pour la voix. En 2026, les modèles vidéo font les deux en une seule génération. Nous en avons testé trois sur un même portrait et une phrase en russe.
1. Comment fonctionne une photo qui parle avec l’IA
La photo devient la première image du clip. Le modèle génère les images suivantes : mouvements des lèvres, expressions, clignements, petits mouvements de tête. Une réplique entre guillemets dans le prompt devient de la parole : le modèle génère une voix et y synchronise les lèvres. C’est ainsi que fonctionnent Veo 3.1, Kling 3.0 et Seedance 2.5 : tous trois créent le son en même temps que la vidéo.
Il existe une seconde voie : charger un enregistrement audio existant. Seedance 2.5 accepte jusqu’à 10 fichiers audio en référence, la parole peut donc être prononcée avec votre propre voix ou une voix enregistrée à l’avance.
2. Faire parler une photo : 4 étapes
- Préparez le portrait. Visage en grand et de face, bouche fermée, lumière homogène. Choisissez le format selon la plateforme : 9:16 pour les stories et les Reels, 16:9 pour YouTube et les présentations.
- Écrivez la réplique. Jusqu’à 12–15 mots pour 8 secondes. La ponctuation fixe les pauses : mettez points et virgules là où l’on reprendrait son souffle.
- Décrivez la voix et le comportement. Langue, timbre, intonation, expressions : « parle d’une voix féminine chaleureuse, cligne des yeux, sourit à la fin ».
- Interdisez le superflu. « Caméra fixe, sans musique, sans sous-titres, sans texte à l’écran » — sinon le modèle peut ajouter une musique ou des incrustations.
3. Quelle photo convient à un avatar qui parle
Nous avons pris le portrait d’une femme tiré de nos prompts pour photo de profil et en avons fait, dans Nano Banana Pro, une image verticale « blogueuse à son bureau ».
Ce qui compte dans l’image :
- La bouche fermée. Le modèle l’ouvre à la première syllabe ; une bouche ouverte sur la photo provoque un sursaut au début du clip.
- Le visage dans la moitié haute. En vidéo verticale, cela laisse de la place à l’interface de la plateforme.
- Rien devant le visage. Des mains, un micro ou des cheveux sur les lèvres gênent la synchronisation.
- Votre photo, ou avec accord. Une vidéo qui parle avec le visage de quelqu’un sans son autorisation est un deepfake, pas un avatar.
4. Test : une réplique dans trois modèles d’IA
Une image, un prompt, 8 secondes, 9:16. La réplique, en russe : «Привет! Это обычное фото, а теперь оно говорит. Сделать так можно за минуту.» (« Salut ! C’est une photo ordinaire, et maintenant elle parle. On peut faire ça en une minute. »)
La femme regarde droit dans l'objectif et parle en russe d'une voix
féminine chaleureuse et naturelle : «Привет! Это обычное фото, а теперь
оно говорит. Сделать так можно за минуту.» Synchronisation labiale
précise, clignements naturels, petits hochements de tête et doux sourire
à la fin, caméra fixe, ambiance calme de pièce, sans musique, sans
sous-titres, sans texte à l'écran
Nous avons comparé les clips image par image et via la piste audio :
| Veo 3.1 | Kling 3.0 | Seedance 2.5 | |
|---|---|---|---|
| Visage et signes distinctifs | conservés | conservés | conservés |
| Début du clip | parle dès la première image | 0,5 s de silence, bouche fermée | 0,6 s de silence, bouche fermée |
| Pauses dans la parole | pas de chute dans le silence | une pause au milieu | quatre phrases, pauses de 0,4–0,9 s |
| Mimique | la plus vivante | posée, façon présentatrice | articulation retenue |
| Fin du clip | parle presque jusqu’au bout | 2 s de silence et un sourire | 0,9 s de silence |
| Durée par génération | jusqu’à 8 s | jusqu’à 15 s | jusqu’à 30 s |
Notre bilan : les trois modèles ont conservé le visage, les taches de rousseur et la créole, et ont doublé la phrase en russe. Veo 3.1 paraît le plus vivant, idéal pour des clips émotionnels sur les réseaux. Kling 3.0 livre un clip posé avec une pause à la fin, pratique pour enchaîner plusieurs répliques. Seedance 2.5 suit la ponctuation le plus fidèlement et est le seul des trois à accepter votre propre enregistrement. Écoutez la prononciation de chaque réplique avant de publier : Google ne publie pas la liste des langues dans lesquelles Veo 3.1 génère de la parole.
5. Faire parler une photo avec votre voix
Si la voix doit être la vôtre, inutile de générer la parole : vous pouvez la fournir au modèle.
- Enregistrez la réplique au téléphone dans une pièce calme, 5–15 secondes.
- Dans Seedance 2.5, chargez le portrait comme première image et le fichier audio comme référence.
- Dans le prompt, précisez que la parole vient de l’audio et que le modèle ne gère que les lèvres, les expressions et les clignements.
La même méthode fonctionne pour une voix off ou une chanson : le modèle synchronise les lèvres sur n’importe quelle piste chargée.
6. Un avatar de dessin animé qui parle
Les photos ne sont pas seules à parler : un personnage illustré aussi. Nous avons pris un avatar 3D de nos prompts et donné à Kling 3.0 une courte réplique en russe : «Всем привет! Я — ваш новый аватар.» (« Salut tout le monde ! Je suis votre nouvel avatar. »)
Les modèles sont plus pardonnés avec les personnages animés : les lèvres sont déjà stylisées, et les petits décalages passent inaperçus. Vérifiez quand même toute l’image : dans notre clip, une main absente du prompt est apparue au bord. Pour créer l’avatar lui-même, voyez notre guide de la photo de profil IA.
7. À quoi sert une photo qui parle
- Réseaux sociaux et stories. Un court message d’accueil, une annonce, une réponse aux abonnés sans tournage.
- Formation et présentations. Un personnage présentateur explique une étape de cours ou une diapositive.
- Publicité et fiches produit. Une personne avec le produit énonce son principal avantage en une phrase.
- Avatar de blog. Le même personnage dans chaque vidéo, sans caméra ni éclairage.
Pour les clips où la photo doit simplement prendre vie sans parler — sourire, cligner des yeux, tourner la tête —, voyez notre guide pour animer une photo avec l’IA.
8. Photo qui parle gratuite : ce qui est réaliste
La vidéo avec son est le type de génération le plus coûteux : les modèles facturent chaque seconde du clip. Il n’existe pas de service totalement gratuit au niveau de Veo 3.1. AI2Face offre des crédits de bienvenue à l’inscription, et le coût de chaque clip s’affiche avant le lancement. Pour dépenser moins, peaufinez la réplique sur 4–5 secondes, puis faites la version finale.
9. Limites et éthique
- Durée. Par génération : jusqu’à 8 secondes dans Veo 3.1, 15 dans Kling 3.0, 30 dans Seedance 2.5. Découpez les longs discours en plusieurs clips.
- Prononciation. Les modèles se trompent parfois d’accent tonique ou lisent mal les mots rares : écoutez chaque clip avant de publier. Écrivez les mots difficiles tels qu’ils se prononcent.
- Détails superflus. Les modèles peuvent ajouter des mains, des objets ou un mouvement de caméra : décrivez dans le prompt ce qui ne doit pas apparaître.
- Visages d’autrui. Ne faites pas parler des personnes qui n’ont pas donné leur accord et ne mettez pas dans la bouche de personnes réelles des mots qu’elles n’ont jamais dits.
- Photos de proches. Animer les archives familiales peut émouvoir, mais la décision revient à la famille ; une vidéo parlante d’une personne disparue peut blesser ses proches.
En résumé
En 2026, une photo qui parle se fait en une seule génération : le portrait en première image, la réplique entre guillemets, une description de la voix, et le modèle double le texte et synchronise les lèvres lui-même. Dans notre test, les trois modèles ont doublé une phrase en russe en conservant le visage. Prenez Veo 3.1 pour des clips vivants et émotionnels jusqu’à 8 secondes, Kling 3.0 pour un ton posé et des répliques enchaînées, Seedance 2.5 pour des clips jusqu’à 30 secondes et votre propre voix. Avant de publier, écoutez chaque clip et vérifiez toute l’image. Sur AI2Face, les trois modèles sont réunis dans un seul générateur, et le coût de chaque clip s’affiche avant le lancement.
Questions fréquentes
Comment faire parler une photo ?
Chargez un portrait comme première image d'une vidéo et écrivez dans le prompt la réplique entre guillemets, la langue et la voix : « parle d'une voix féminine chaleureuse : “…” ». Veo 3.1, Kling 3.0 et Seedance 2.5 doublent le texte et synchronisent les lèvres en une génération.
Quelle IA fait parler une photo dans d'autres langues que l'anglais ?
Dans notre test, les trois modèles — Veo 3.1, Kling 3.0 et Seedance 2.5 — ont doublé une phrase en russe. Veo 3.1 avait la mimique la plus vivante, Seedance 2.5 les pauses les plus nettes entre les phrases, Kling 3.0 le clip le plus posé, façon présentatrice.
Peut-on faire parler une photo avec sa propre voix ?
Oui. Seedance 2.5 accepte jusqu'à 10 fichiers audio en référence : chargez un enregistrement de votre voix et précisez dans le prompt que la parole en provient. Sans audio, les modèles génèrent une voix d'après votre description.
Peut-on créer une photo qui parle gratuitement ?
En partie. AI2Face offre des crédits de bienvenue à l'inscription. La vidéo avec son coûte plus cher que les images : commencez par un clip de 4–5 secondes. Le coût s'affiche avant le lancement.
Quelle durée peut avoir une vidéo qui parle ?
Par génération, Veo 3.1 produit jusqu'à 8 secondes, Kling 3.0 jusqu'à 15 et Seedance 2.5 jusqu'à 30. En 8 secondes tient une phrase de 12–15 mots ; découpez les textes longs en plusieurs clips.
Sources
3
- https://ai.google.dev/gemini-api/docs/veo
- https://kling.ai/quickstart/klingai-video-3-omni-model-user-guide
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5