Una foto parlante è un video in cui la persona di un ritratto guarda in camera e pronuncia un testo: le labbra seguono le parole, gli occhi sbattono, la testa si muove leggermente. Prima servivano due strumenti: uno per animare il volto, un altro per la voce. Nel 2026 i modelli video fanno entrambe le cose in una sola generazione. Ne abbiamo provati tre su un solo ritratto e una frase in russo.
1. Come funziona una foto parlante con IA
La foto diventa il primo fotogramma della clip. Il modello genera i fotogrammi successivi: movimento delle labbra, espressioni, battito di ciglia, piccoli movimenti della testa. Una battuta tra virgolette nel prompt diventa parlato: il modello genera una voce e sincronizza le labbra. Così funzionano Veo 3.1, Kling 3.0 e Seedance 2.5: tutti e tre creano l’audio insieme al video.
C’è anche una seconda strada: caricare una registrazione audio già pronta. Seedance 2.5 accetta fino a 10 file audio come riferimento, quindi il parlato può avere la tua voce o una voce registrata in precedenza.
2. Come far parlare una foto: 4 passaggi
- Prepara il ritratto. Volto grande e frontale, bocca chiusa, luce uniforme. Scegli il formato in base alla piattaforma: 9:16 per storie e Reel, 16:9 per YouTube e presentazioni.
- Scrivi la battuta. Fino a 12–15 parole per 8 secondi. La punteggiatura decide le pause, quindi metti punti e virgole dove una persona prenderebbe fiato.
- Descrivi voce e comportamento. Lingua, timbro, intonazione, espressione: «parla con una calda voce femminile, sbatte le ciglia, sorride alla fine».
- Vieta il superfluo. «Camera fissa, niente musica, niente sottotitoli, niente testo a schermo», altrimenti il modello può aggiungere musica o scritte.
3. Quale foto va bene per un avatar parlante
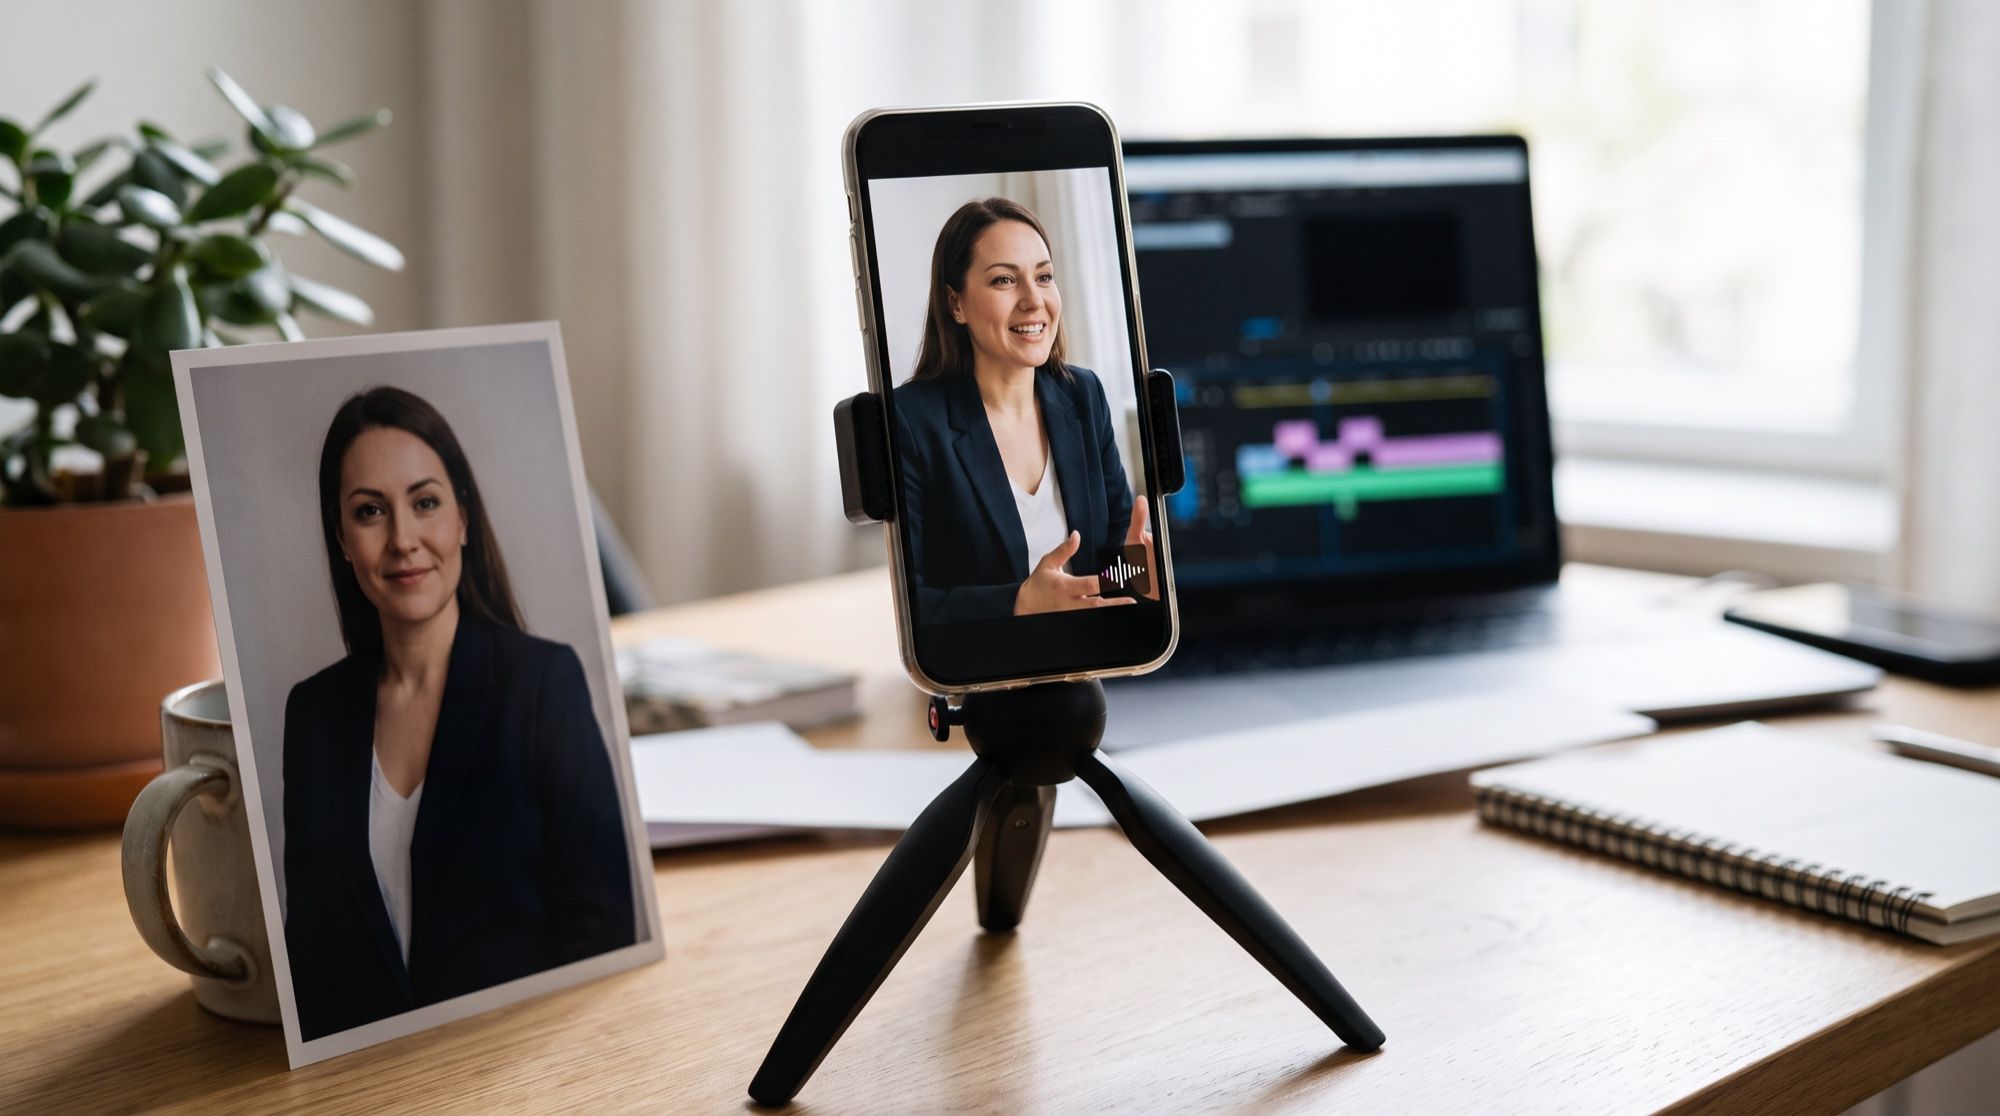
Abbiamo preso il ritratto di una donna dai nostri prompt per foto profilo e ne abbiamo ricavato in Nano Banana Pro un’inquadratura verticale da «blogger alla scrivania».
Cosa conta nell’inquadratura:
- Bocca chiusa. Il modello la apre alla prima sillaba; una bocca aperta nella foto causa uno scatto all’inizio della clip.
- Volto nella metà superiore. Nei video verticali resta spazio per l’interfaccia della piattaforma.
- Niente davanti al volto. Mani, microfono o capelli sulle labbra disturbano la sincronizzazione.
- La tua foto o con consenso. Un video parlante con il volto di un’altra persona senza permesso è un deepfake, non un avatar.
4. Test: una battuta in tre modelli di IA
Un’immagine, un prompt, 8 secondi, 9:16. La battuta, in russo: «Привет! Это обычное фото, а теперь оно говорит. Сделать так можно за минуту.» («Ciao! Questa è una foto normale, e ora parla. Si fa in un minuto.»)
La donna guarda dritto in camera e parla in russo con una voce femminile
calda e naturale: «Привет! Это обычное фото, а теперь оно говорит.
Сделать так можно за минуту.» Sincronizzazione labiale precisa, battito
di ciglia naturale, piccoli cenni del capo e un sorriso morbido alla
fine, camera fissa, atmosfera tranquilla della stanza, niente musica,
niente sottotitoli, niente testo a schermo
Abbiamo confrontato le clip fotogramma per fotogramma e sulla traccia audio:
| Veo 3.1 | Kling 3.0 | Seedance 2.5 | |
|---|---|---|---|
| Volto e tratti | mantenuti | mantenuti | mantenuti |
| Inizio della clip | parla dal primo fotogramma | 0,5 s di silenzio, bocca chiusa | 0,6 s di silenzio, bocca chiusa |
| Pause nel parlato | nessun vuoto di silenzio | una pausa a metà | quattro frasi, pause di 0,4–0,9 s |
| Mimica | la più viva | pacata, da conduttrice | articolazione contenuta |
| Fine della clip | parla quasi fino alla fine | 2 s di silenzio e un sorriso | 0,9 s di silenzio |
| Durata per generazione | fino a 8 s | fino a 15 s | fino a 30 s |
La nostra conclusione: tutti e tre i modelli hanno mantenuto volto, lentiggini e orecchino e hanno dato voce alla frase in russo. Veo 3.1 sembra il più vivo, ottimo per clip emozionali sui social. Kling 3.0 dà una clip pacata con una pausa finale, comoda per unire più battute. Seedance 2.5 segue la punteggiatura con più precisione ed è l’unico dei tre che accetta la tua registrazione. Ascolta la pronuncia di ogni battuta prima di pubblicare: Google non pubblica l’elenco delle lingue in cui Veo 3.1 genera il parlato.
5. Far parlare una foto con la tua voce
Se la voce dev’essere la tua, non serve generarla: puoi fornirla al modello.
- Registra la battuta con il telefono in una stanza silenziosa, 5–15 secondi.
- Carica in Seedance 2.5 il ritratto come primo fotogramma e il file audio come riferimento.
- Nel prompt scrivi che il parlato viene dall’audio e che il modello gestisce solo labbra, espressioni e battito di ciglia.
Lo stesso metodo vale per una voce fuori campo o una canzone: il modello sincronizza le labbra con qualsiasi traccia caricata.
6. Un avatar animato che parla
Non parlano solo le foto: anche un personaggio illustrato. Abbiamo preso un avatar 3D dai nostri prompt e dato a Kling 3.0 una breve battuta in russo: «Всем привет! Я — ваш новый аватар.» («Ciao a tutti! Sono il vostro nuovo avatar.»)
Ai personaggi animati i modelli fanno passare di più: le labbra sono già stilizzate e i piccoli errori di sincronizzazione non si notano. Controlla comunque l’inquadratura intera: nella nostra clip è comparsa sul bordo una mano che non era nel prompt. Come creare l’avatar lo spieghiamo nella guida alla foto profilo con IA.
7. A cosa serve una foto parlante
- Social e storie. Un breve saluto, un annuncio, una risposta ai follower senza girare.
- Formazione e presentazioni. Un personaggio conduttore spiega un passaggio della lezione o una slide.
- Pubblicità e schede prodotto. Una persona con il prodotto ne dice in una frase il vantaggio principale.
- Avatar per il blog. Lo stesso personaggio in ogni video, senza telecamera né luci.
Per clip in cui la foto deve solo prendere vita senza parlare — sorridere, sbattere le ciglia, girare la testa — leggi la nostra guida per animare una foto con l’IA.
8. Foto parlante gratis: cosa è realistico
Il video con audio è il tipo di generazione più costoso: i modelli fanno pagare ogni secondo della clip. Non esistono servizi del tutto gratuiti con la qualità di Veo 3.1. AI2Face assegna crediti di benvenuto alla registrazione e il costo di ogni clip è visibile prima dell’avvio. Per spendere meno, prova la battuta su 4–5 secondi e solo dopo crea la versione finale.
9. Limiti ed etica
- Durata. Per generazione: fino a 8 secondi in Veo 3.1, 15 in Kling 3.0, 30 in Seedance 2.5. I discorsi lunghi vanno divisi in più clip.
- Pronuncia. A volte i modelli sbagliano l’accento o leggono male parole rare: ascolta ogni clip prima di pubblicare. Scrivi le parole difficili come si pronunciano.
- Dettagli in più. I modelli possono aggiungere mani, oggetti o movimenti di camera: descrivi nel prompt cosa non deve esserci.
- Volti altrui. Non creare video parlanti con persone che non hanno dato il consenso e non mettere in bocca a persone reali parole mai dette.
- Foto di familiari. Animare l’archivio di famiglia può commuovere, ma la decisione spetta alla famiglia; un video parlante di una persona scomparsa può ferire i propri cari.
In sintesi
Nel 2026 una foto parlante nasce da una sola generazione: il ritratto come primo fotogramma, la battuta tra virgolette, la descrizione della voce, e il modello dà voce al testo e sincronizza le labbra da solo. Nel nostro test tutti e tre i modelli hanno dato voce a una frase in russo mantenendo il volto. Usa Veo 3.1 per clip vivaci ed emozionali fino a 8 secondi, Kling 3.0 per un tono pacato e per unire più battute, Seedance 2.5 per clip fino a 30 secondi e per parlare con la tua registrazione. Prima di pubblicare, ascolta ogni clip e controlla l’inquadratura intera. In AI2Face i tre modelli sono nello stesso generatore e il costo di ogni clip è visibile prima dell’avvio.
Domande frequenti
Come si fa parlare una foto?
Carica un ritratto come primo fotogramma del video e scrivi nel prompt la battuta tra virgolette, la lingua e la voce: «parla con una calda voce femminile: “…”». Veo 3.1, Kling 3.0 e Seedance 2.5 danno voce al testo e sincronizzano le labbra in una sola generazione.
Quale IA fa parlare una foto in lingue diverse dall'inglese?
Nel nostro test tutti e tre i modelli — Veo 3.1, Kling 3.0 e Seedance 2.5 — hanno dato voce a una frase in russo. Veo 3.1 ha avuto la mimica più viva, Seedance 2.5 le pause più nette tra le frasi, Kling 3.0 la clip più pacata, da conduttrice.
Posso far parlare una foto con la mia voce?
Sì. Seedance 2.5 accetta fino a 10 file audio come riferimento: carica una registrazione della tua voce e indica nel prompt che il parlato viene da lì. Senza audio, i modelli generano una voce in base alla tua descrizione.
Si può creare una foto parlante gratis?
In parte. AI2Face assegna crediti di benvenuto alla registrazione. Il video con audio costa più delle immagini, quindi inizia con una clip di 4–5 secondi. Il costo è visibile prima dell'avvio.
Quanto può durare un video parlante?
Per generazione Veo 3.1 arriva a 8 secondi, Kling 3.0 a 15 e Seedance 2.5 a 30. In 8 secondi sta una frase di 12–15 parole; i testi lunghi vanno divisi in più clip.
Fonti
3
- https://ai.google.dev/gemini-api/docs/veo
- https://kling.ai/quickstart/klingai-video-3-omni-model-user-guide
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5