Говорящее фото — это видео, в котором человек с портрета смотрит в камеру и произносит нужный текст: губы двигаются в такт словам, моргают глаза, слегка двигается голова. Раньше для этого нужны были два сервиса: один анимировал лицо, другой озвучивал текст. Видеомодели 2026 года делают и то и другое за одну генерацию. Мы проверили три из них на одном портрете и одной фразе на русском.
1. Как нейросеть делает говорящее фото
Фото становится первым кадром ролика. Модель достраивает следующие кадры: движение губ, мимику, моргание, мелкие повороты головы. Реплика в кавычках в промпте превращается в речь — модель генерирует голос и синхронизирует с ним губы. Так работают Veo 3.1, Kling 3.0 и Seedance 2.5: у всех трёх звук создаётся вместе с видео.
Есть и второй путь: загрузить готовую аудиозапись. Seedance 2.5 принимает до 10 аудиофайлов как референсы, так что речь может звучать вашим голосом или голосом, записанным заранее.
2. Как сделать говорящее фото: 4 шага
- Подготовьте портрет. Лицо крупно и анфас, рот закрыт, ровный свет. Формат — под площадку: 9:16 для сторис и Reels, 16:9 для YouTube и презентаций.
- Напишите реплику. До 12–15 слов на 8 секунд. Знаки препинания задают паузы, поэтому ставьте точки и запятые там, где человек переводит дыхание.
- Опишите голос и поведение. Язык, тембр, интонацию, мимику: «говорит по-русски тёплым женским голосом, моргает, в конце улыбается».
- Запретите лишнее. «Камера неподвижна, без музыки, без субтитров, без текста на экране» — иначе модель может добавить фон или надписи.
3. Какое фото подходит для говорящего аватара
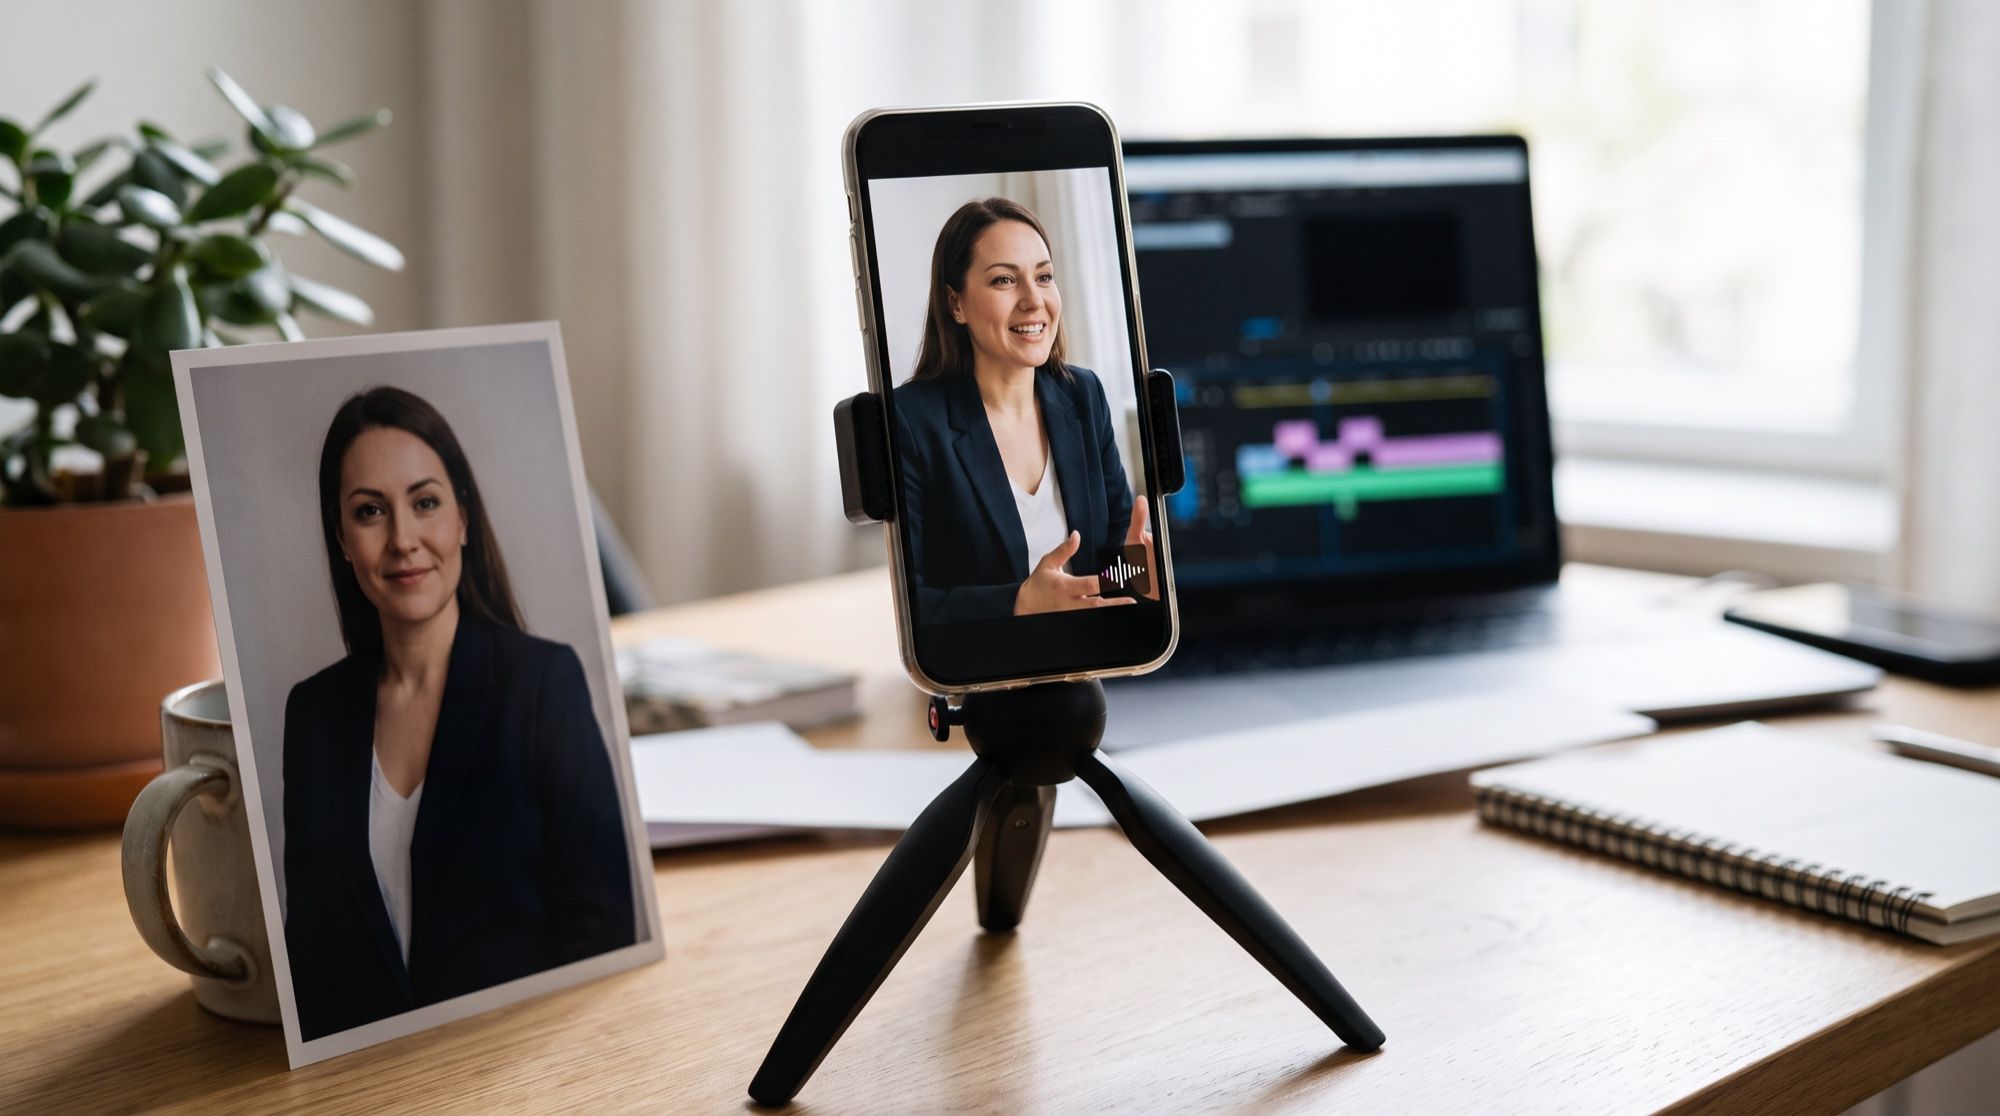
Мы взяли портрет девушки из нашего гайда по промтам для аватарки и сделали из него вертикальный кадр «блогер за столом» в Nano Banana Pro.
Что важно в кадре:
- Рот закрыт. Модель сама откроет его на первом слоге; открытый рот на фото даёт рывок в начале ролика.
- Лицо в верхней половине кадра. В вертикальном видео так остаётся место под интерфейс площадки.
- Ничего у лица. Руки, микрофон, волосы на губах мешают синхронизации.
- Своё фото или с согласия. Говорящее видео с чужим лицом без разрешения — уже дипфейк, а не аватар.
4. Тест: одна реплика в трёх нейросетях
Один кадр, один промпт, 8 секунд, формат 9:16. Реплика: «Привет! Это обычное фото, а теперь оно говорит. Сделать так можно за минуту.»
Девушка смотрит прямо в камеру и говорит по-русски тёплым естественным
женским голосом: «Привет! Это обычное фото, а теперь оно говорит.
Сделать так можно за минуту.» Точная синхронизация губ, естественное
моргание, лёгкие кивки, в конце мягкая улыбка, камера неподвижна,
тихая атмосфера комнаты, без музыки, без субтитров, без текста на экране
Мы сравнили ролики покадрово и по звуковой дорожке:
| Veo 3.1 | Kling 3.0 | Seedance 2.5 | |
|---|---|---|---|
| Лицо и приметы | сохранены | сохранены | сохранены |
| Начало ролика | говорит с первого кадра | 0,5 с тишины, рот закрыт | 0,6 с тишины, рот закрыт |
| Паузы в речи | без провалов в тишину | одна пауза посередине | четыре фразы, паузы 0,4–0,9 с |
| Мимика | самая выразительная | спокойная, «дикторская» | сдержанная артикуляция |
| Конец ролика | речь почти до конца | 2 с тишины и улыбка | 0,9 с тишины |
| Длина за генерацию | до 8 с | до 15 с | до 30 с |
Выводы теста: все три модели сохранили лицо, веснушки и серёжку и озвучили русскую реплику. Veo 3.1 выглядит живее всех — подходит для эмоциональных роликов в соцсети. Kling 3.0 даёт ровный спокойный ролик с паузой в конце — удобно склеивать несколько фраз подряд. Seedance 2.5 точнее всех следует пунктуации и единственная из трёх принимает свою аудиозапись. Произношение конкретной фразы перед публикацией проверяйте на слух: Google не публикует список языков, на которых Veo 3.1 озвучивает речь.
5. Как озвучить фото своим голосом
Если голос должен быть вашим, генерировать речь не нужно — её можно передать модели.
- Запишите реплику на телефон в тихой комнате, 5–15 секунд.
- Загрузите портрет как первый кадр и аудиофайл как референс в Seedance 2.5.
- В промпте напишите, что речь берётся из аудио, а модель отвечает только за губы, мимику и моргание.
Этот же способ подходит для озвучки диктором или для песни: модель синхронизирует губы с любой загруженной дорожкой.
6. Говорящий мультяшный аватар
Говорить может не только фотография, но и рисованный персонаж. Мы взяли 3D-аватар из гайда по промтам и дали Kling 3.0 короткую реплику «Всем привет! Я — ваш новый аватар.»
Мультяшным персонажам модели прощают больше: губы и так стилизованы, и небольшие неточности синхронизации незаметны. Но кадр всё равно проверяйте целиком — в нашем ролике у края появилась рука, которой не было в промпте. Как сделать саму аватарку, разбираем в гайде аватарка нейросетью.
7. Для чего нужно говорящее фото
- Соцсети и сторис. Короткое приветствие, анонс, ответ подписчикам без съёмки.
- Обучение и презентации. Персонаж-ведущий объясняет шаг урока или слайд.
- Реклама и карточки товаров. Человек с товаром произносит одну фразу о главном преимуществе.
- Аватар для блога. Один и тот же персонаж в каждом ролике — без камеры и света.
Для роликов, где фото должно просто ожить без речи — улыбнуться, моргнуть, повернуть голову, — подойдёт гайд оживить фото.
8. Говорящее фото бесплатно: что реально
Видео со звуком — самый дорогой тип генерации: модели считают каждую секунду ролика. Полностью бесплатных сервисов с качеством уровня Veo 3.1 нет. В AI2Face после регистрации начисляются стартовые кредиты, а стоимость каждого ролика видна до запуска. Чтобы потратить меньше, отлаживайте реплику на 4–5 секундах и только потом делайте финальную версию.
9. Ограничения и этика
- Длина. За одну генерацию — до 8 секунд у Veo 3.1, до 15 у Kling 3.0, до 30 у Seedance 2.5. Длинную речь делите на ролики.
- Произношение. Ударения и редкие слова модели иногда читают неправильно — слушайте каждый ролик перед публикацией. Сложные слова пишите так, как они звучат.
- Лишние детали. Модели могут добавить руки, предметы или движение камеры — описывайте в промпте, чего быть не должно.
- Чужие лица. Не делайте говорящие видео с людьми, которые на это не соглашались, и не вкладывайте в уста реальных людей слова, которых они не говорили.
- Фото родственников. Оживление семейного архива трогает, но решение — за семьёй; говорящее видео с умершим человеком может ранить близких.
Выводы
Говорящее фото в 2026 году делается одной генерацией: портрет как первый кадр, реплика в кавычках, описание голоса — и модель сама озвучит текст и синхронизирует губы. В нашем тесте русскую фразу озвучили все три модели, сохранив лицо. Veo 3.1 — для живых эмоциональных роликов до 8 секунд, Kling 3.0 — для спокойной подачи и склейки фраз, Seedance 2.5 — для роликов до 30 секунд и озвучки своим голосом. Перед публикацией слушайте каждый ролик и проверяйте кадр целиком. В AI2Face все три модели работают из России без VPN в одном генераторе, оплата — картой российского банка, по СБП или криптовалютой, а стоимость ролика видна до запуска.
Частые вопросы
Как заставить фото говорить?
Загрузите портрет как первый кадр видео и напишите в промпте реплику в кавычках, язык и голос: «говорит по-русски тёплым женским голосом: „…“». Veo 3.1, Kling 3.0 и Seedance 2.5 озвучат текст и синхронизируют губы за одну генерацию.
Какая нейросеть делает говорящее фото с русской речью?
В нашем тесте русскую реплику озвучили все три модели: Veo 3.1, Kling 3.0 и Seedance 2.5. Самая выразительная мимика — у Veo 3.1, самые чёткие паузы между фразами — у Seedance 2.5, самый спокойный «дикторский» ролик — у Kling 3.0.
Можно ли озвучить фото своим голосом?
Да. Seedance 2.5 принимает до 10 аудиофайлов как референсы — загрузите запись своего голоса и укажите в промпте, что речь берётся из неё. Без аудио модели генерируют голос сами по описанию.
Можно ли сделать говорящее фото бесплатно?
Частично. В AI2Face после регистрации начисляются стартовые кредиты. Видео со звуком дороже картинок, поэтому начните с короткого ролика на 4–5 секунд. Стоимость видна до запуска.
Какой длины может быть говорящее видео?
За одну генерацию Veo 3.1 делает до 8 секунд, Kling 3.0 — до 15, Seedance 2.5 — до 30. На 8 секунд помещается фраза из 12–15 слов; длинный текст делите на несколько роликов.
Источники
3
- https://ai.google.dev/gemini-api/docs/veo
- https://kling.ai/quickstart/klingai-video-3-omni-model-user-guide
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5