喋る写真とは、肖像の人物がカメラを見て指定した文章を話す動画です。口が言葉に合わせて動き、まばたきし、頭が少し動きます。以前は2つのツールが必要でした。顔を動かすツールと、文章に声を付けるツールです。2026年の動画モデルは、その両方を1回の生成でこなします。そのうち3つを、1枚の肖像とロシア語の1文でテストしました。
1. AIが写真を喋らせる仕組み
写真が動画の最初のフレームになります。モデルはそこから続くフレームを作ります。口の動き、表情、まばたき、小さな首の動きです。プロンプト内のかぎかっこのセリフは音声になり、モデルが声を生成して口の動きを同期させます。Veo 3.1、Kling 3.0、Seedance 2.5 はこの方式で、3つとも音声を映像と同時に作ります。
もう1つの方法は、録音済みの音声をアップロードすることです。Seedance 2.5 は最大10個の音声ファイルを参照として受け付けるので、自分の声や事前に録った声で話させられます。
2. 写真を喋らせる4ステップ
- 肖像を用意する。 顔を大きく正面から、口は閉じて、光は均一に。比率は投稿先に合わせます。ストーリーズや Reels なら9:16、YouTube やプレゼンなら16:9です。
- セリフを書く。 8秒なら12〜15語まで。句読点が間を決めるので、息つぎする位置に句点や読点を入れます。
- 声と動きを書く。 言語、声質、話し方、表情。例:「温かい女性の声で話し、まばたきし、最後に微笑む」。
- 余計なものを禁止する。 「カメラ固定、音楽なし、字幕なし、画面に文字なし」。書かないと、モデルがBGMや字幕を足すことがあります。
3. 喋るアバターに向く写真
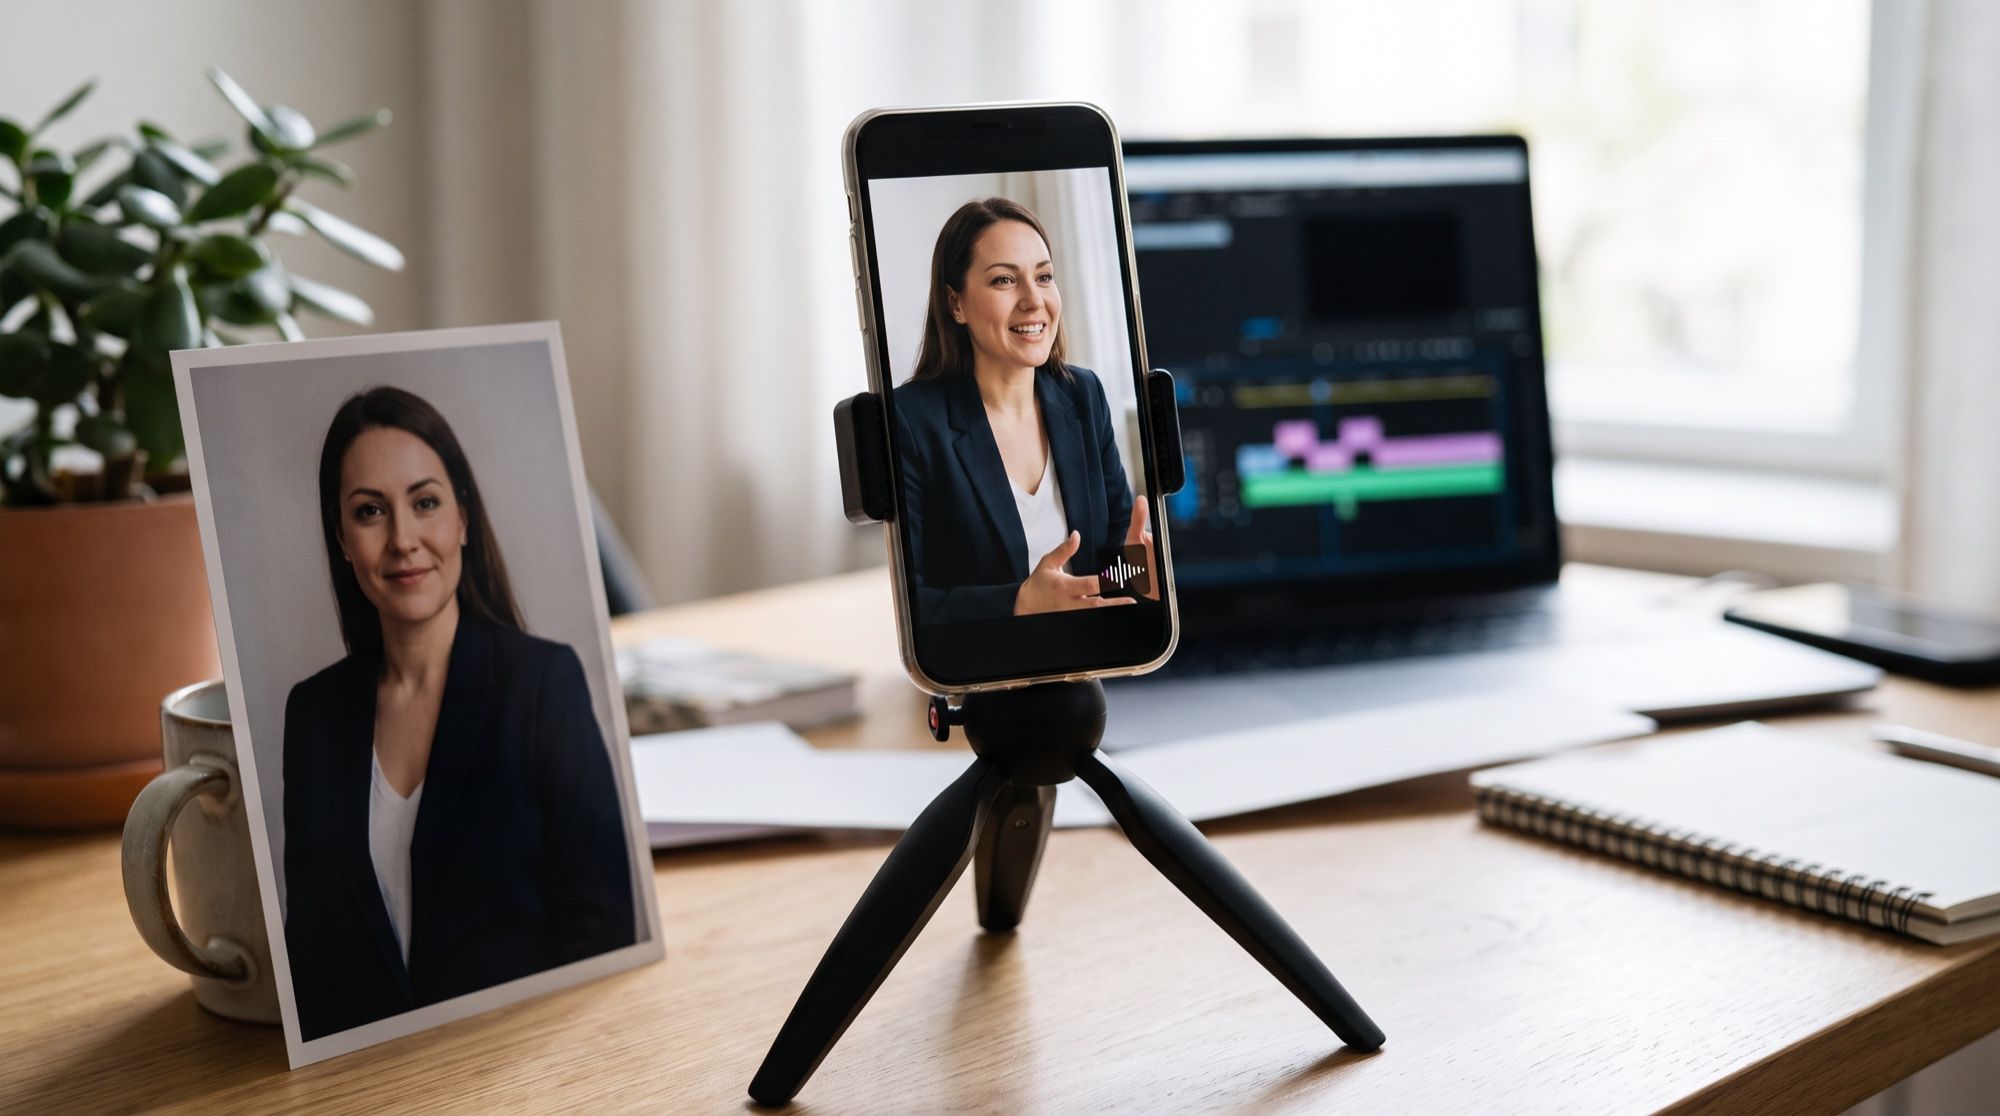
アイコン用プロンプト のガイドに出てきた女性の肖像を使い、Nano Banana Pro で「デスクに座るブロガー」の縦長フレームにしました。
フレームで大事な点:
- 口を閉じる。 モデルは最初の音節で自分から口を開けます。写真で口が開いていると、動画の冒頭で映像が跳びます。
- 顔はフレームの上半分に。 縦動画では、そのほうが投稿先のUIの分だけ余白が残ります。
- 顔の近くに何も置かない。 手、マイク、唇にかかる髪はリップシンクの邪魔になります。
- 自分の写真か、本人の同意を得た写真で。 他人の顔を無断で喋らせる動画は、アバターではなくディープフェイクです。
4. テスト:同じセリフを3つのモデルで
同じフレーム、同じプロンプト、8秒、9:16。セリフはロシア語です:«Привет! Это обычное фото, а теперь оно говорит. Сделать так можно за минуту.»(「こんにちは!これは普通の写真ですが、いまは喋ります。1分でできます。」)
The woman looks straight into the camera and speaks in Russian in a warm,
natural female voice: «Привет! Это обычное фото, а теперь оно говорит.
Сделать так можно за минуту.» Accurate lip sync, natural blinking, small
head nods and a soft smile at the end, static camera, quiet room
ambience, no music, no subtitles, no text on screen
動画をフレームごと、音声トラックごとに比較しました:
| Veo 3.1 | Kling 3.0 | Seedance 2.5 | |
|---|---|---|---|
| 顔と特徴 | 維持 | 維持 | 維持 |
| 動画の冒頭 | 最初のフレームから話す | 0.5秒の無音、口は閉じている | 0.6秒の無音、口は閉じている |
| 発話中の間 | 無音の途切れなし | 中ほどに1回 | 4フレーズ、間は0.4〜0.9秒 |
| 表情 | いちばん豊か | 落ち着いたアナウンサー風 | 控えめな口の動き |
| 動画の終わり | ほぼ最後まで話す | 2秒の無音と微笑み | 0.9秒の無音 |
| 1回の生成の長さ | 最長8秒 | 最長15秒 | 最長30秒 |
テストの結論:3つのモデルとも顔、そばかす、イヤリングを保ち、ロシア語のセリフを話しました。いちばん生き生きして見えるのは Veo 3.1 で、感情の伝わるSNS向け動画に合います。Kling 3.0 は落ち着いたなめらかな動画で最後に間があり、複数のセリフをつなぐのに便利です。Seedance 2.5 は句読点にいちばん忠実で、3つの中で唯一、自分の録音を受け付けます。公開前にはセリフの発音を耳で確認してください。Google は Veo 3.1 が音声を生成できる言語の一覧を公開していません。
5. 自分の声で写真を喋らせる方法
声を自分のものにしたいなら、音声を生成する必要はありません。モデルに渡せます。
- 静かな部屋でスマホにセリフを録音します。5〜15秒。
- Seedance 2.5 で、肖像を最初のフレームとして、音声ファイルを参照としてアップロードします。
- プロンプトに、音声は録音から取り、モデルは口の動き、表情、まばたきだけを担当すると書きます。
同じ方法はナレーターの吹き替えや歌にも使えます。モデルはアップロードしたどの音声トラックにも口の動きを合わせます。
6. 喋るアニメ風アバター
喋れるのは写真だけではありません。イラストのキャラクターも話せます。プロンプトのガイドの3Dアバターを使い、Kling 3.0 にロシア語の短いセリフを渡しました:«Всем привет! Я — ваш новый аватар.»(「みなさん、こんにちは!新しいアバターです。」)
アニメ風キャラクターでは、モデルの粗が目立ちにくくなります。口はもともとデフォルメされているので、小さな同期のずれは気づかれません。それでもフレーム全体は確認してください。今回の動画では、プロンプトにない手が端に現れました。アバター自体の作り方は、ガイド AIでアイコン作成 で解説しています。
7. 喋る写真の使いみち
- SNSとストーリーズ。 短いあいさつ、告知、フォロワーへの返信を撮影なしで。
- 教育とプレゼン。 進行役のキャラクターが授業の手順やスライドを説明します。
- 広告と商品ページ。 商品を持った人物が、いちばんの利点を1文で話します。
- ブログのアバター。 どの動画にも同じキャラクター。カメラも照明も不要です。
話さずに写真がただ動けばいい場合、つまり微笑む、まばたきする、振り向くといった動画には、ガイド 写真を動画に が合います。
8. 無料で写真を喋らせる:現実的な線
音声付き動画は、いちばん高い種類の生成です。モデルは動画の1秒ごとに料金がかかります。Veo 3.1 並みの品質で完全に無料のサービスはありません。AI2Face では登録後にスタート用クレジットが付与され、各動画の料金は実行前に表示されます。節約するなら、4〜5秒でセリフを詰めてから最終版を作ってください。
9. 制限と倫理
- 長さ。 1回の生成で Veo 3.1 は最長8秒、Kling 3.0 は最長15秒、Seedance 2.5 は最長30秒。長いスピーチは複数の動画に分けます。
- 発音。 モデルはアクセントやめずらしい単語を読み違えることがあります。公開前にすべての動画を聞いてください。読みにくい単語は発音どおりに書きます。
- 余計なディテール。 モデルが手や物、カメラの動きを足すことがあります。出てほしくないものはプロンプトに書きます。
- 他人の顔。 同意していない人の喋る動画は作らず、実在の人物に本人が言っていない言葉を言わせないでください。
- 家族の写真。 家族の古い写真を動かすのは心を動かしますが、決めるのは家族です。亡くなった人の喋る動画は、近しい人を傷つけることがあります。
まとめ
2026年、写真を喋らせるのは1回の生成で済みます。肖像を最初のフレームに、セリフをかぎかっこに入れ、声を説明すれば、モデルが音声を付けて口の動きを合わせます。今回のテストでは3つのモデルとも顔を保ったままロシア語のセリフを話しました。8秒までの生き生きした感情的な動画には Veo 3.1、落ち着いた語りやセリフのつなぎには Kling 3.0、最長30秒の動画や自分の録音での吹き替えには Seedance 2.5 を使ってください。公開前には各動画を聞き、フレーム全体を確認します。AI2Face では3つのモデルが1つのジェネレーターにそろっていて、各動画の料金は実行前に表示されます。
よくある質問
写真を喋らせるには?
肖像を動画の最初のフレームとしてアップロードし、プロンプトにセリフをかぎかっこで書いて、言語と声を指定します。例:「温かい女性の声で話す:『……』」。Veo 3.1、Kling 3.0、Seedance 2.5 は1回の生成で音声を付け、口の動きを合わせます。
英語以外の言語で写真を喋らせられるモデルは?
今回のテストでは、Veo 3.1、Kling 3.0、Seedance 2.5 の3つともロシア語のセリフを話しました。表情がいちばん豊かなのは Veo 3.1、フレーズ間の間がいちばん明確なのは Seedance 2.5、いちばん落ち着いたアナウンサー風の動画は Kling 3.0 でした。
自分の声で写真を喋らせられますか?
はい。Seedance 2.5 は最大10個の音声ファイルを参照として受け付けます。自分の声の録音をアップロードし、プロンプトで音声はその録音から取ると指定します。音声がなければ、モデルが説明に沿って声を生成します。
無料で写真を喋らせられますか?
一部は可能です。AI2Face では登録後にスタート用クレジットが付与されます。音声付き動画は画像より高いので、まず4〜5秒の短い動画から始めてください。料金は実行前に表示されます。
喋る動画はどのくらいの長さにできますか?
1回の生成で、Veo 3.1 は最長8秒、Kling 3.0 は最長15秒、Seedance 2.5 は最長30秒です。8秒に収まるのは12〜15語ほどの1文です。長い文章は複数の動画に分けてください。
出典
3
- https://ai.google.dev/gemini-api/docs/veo
- https://kling.ai/quickstart/klingai-video-3-omni-model-user-guide
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5