关键信息
| 开发者 | Google DeepMind |
|---|---|
| 发布日期 | 发布于 2026 年 5 月(Google I/O);Omni 1.1 Flash 于 2026 年 8 月 27 日 |
| 功能 | 根据文字、图像和视频生成并编辑有声视频 |
| 时长 | 单次 3–10 秒,每次延长 10 秒,最长 40 秒 |
| 分辨率 | 360p、720p;1080p 和 4K 靠放大;每秒 24 帧 |
| 画幅 | 16:9 和 9:16 |
| 参考 | 图像,以及最多 3 段各 3 秒的视频 |
| 声音 | 与画面一起生成 |
| 标记 | 不可见的 SynthID 水印 |
| 在 AI2Face | 有,生成器里是 Omni 1.1 Flash |
Gemini Omni 是什么
Gemini Omni 是 Google DeepMind 的一组模型,能从任意输入做出内容。最先落地的是视频。Google 在 2026 年 5 月的 I/O 上展示了它,并这样描述:“想象一下 Nano Banana,但是做视频”——每一步都可以用普通句子接着改。
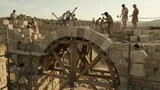
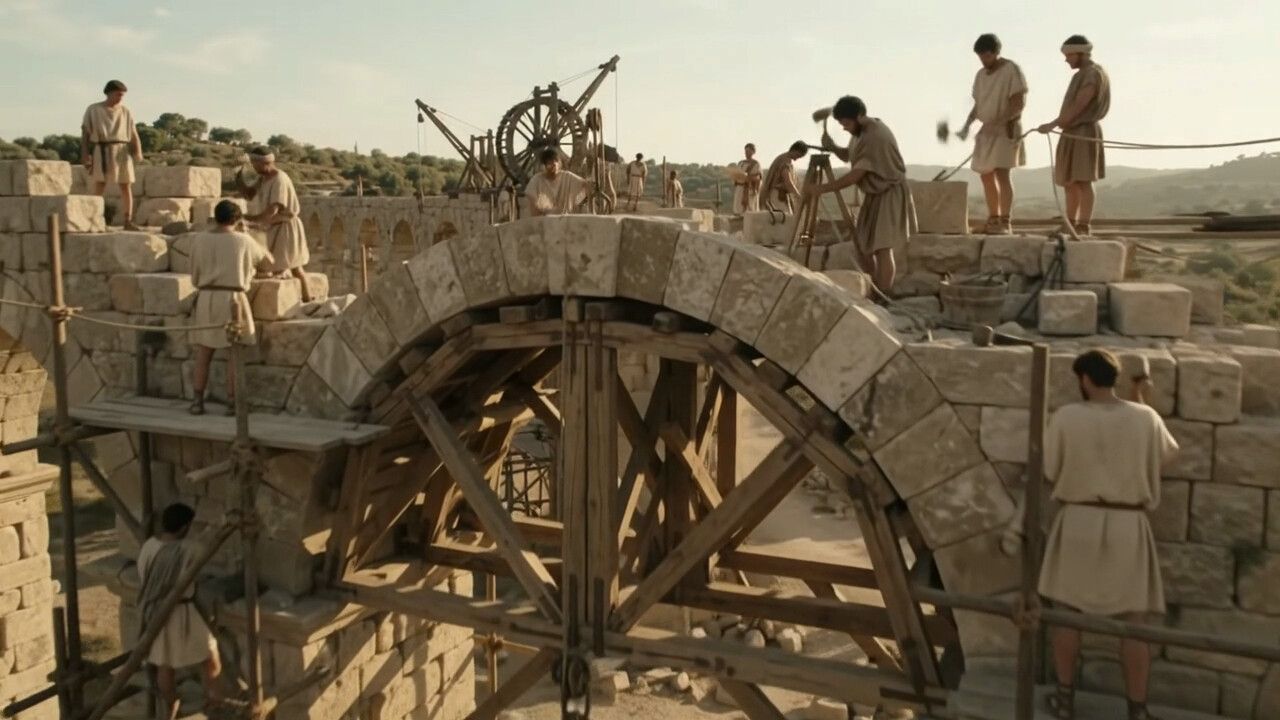
Omni 用的是 Gemini 对世界的了解:物理、历史、科学和文化。所以“公元 1 世纪修建渡槽”或“船闸怎么工作”这类场景,出来的细节说得通,而不只是好看。
2026 年 8 月 27 日发布了 Omni 1.1 Flash,稳定版,能延长场景、控制首帧和尾帧、用 360p 出草稿,并输出到 4K。在 Gemini API 文档里,Google 把它推荐为默认视频模型,把 Veo 3.1 留给特定任务。
Gemini Omni 能做什么
世界知识。 如果要求的是真实语境里的场景,模型会自己补上历史上和物理上说得通的细节。
多张参考合成一个场景。 人物来自一张照片,裙子来自另一张,阁楼来自第三张。Omni 把它们收成一条片子,并保住外形。
修改成片。 和 Veo 的主要差别:上传视频,写明要改什么——天气、衣服、光线、物体、镜头运动。每一次修改都接在上一次之上。
首帧和尾帧。 两张图,模型做出带声音的过渡。
让照片动起来。 图像成为片段的第一帧:烟、水滴、镜头运动。
延长。 在 API 里,片段按 10 秒一步延长,最长 40 秒。模型会参考之前最多 10 秒的视频,而不只是最后一帧。
Gemini Omni 适合什么任务
- 改已有成片: 换天气、时段、衣服,或去掉一个物体,不用重拍。
- 教育和历史场景, 细节要说得通。
- 用商品照片做广告: 静物变成短片。
- 带声音的竖屏短片, 给社交平台用。
- 快速迭代: 360p 出草稿,1080p 或 4K 出成片。
Gemini Omni 和同类模型
| Gemini Omni 1.1 Flash | Veo 3.1 | Seedance 2.5 | |
|---|---|---|---|
| 开发者 | Google DeepMind | Google DeepMind | ByteDance Seed |
| 单次时长 | 3–10 秒 | 4、6、8 秒 | 最长 30 秒 |
| 延长 | 最长 40 秒 | 最长 148 秒(API,720p) | 2 次 |
| 分辨率 | 最高 4K(放大) | 最高 4K | 未公布 |
| 输入 | 文字、图像、视频 | 文字、最多 3 张图 | 文字、30 张照片、10 段视频、10 段音频 |
| 修改成片 | 可以,用句子 | 不行 | 可以 |
| 语音语言 | 完整支持英语 | 未公布 | 未公布 |
| 在 AI2Face | 有 | 有 | 有 |
Omni 是 Google 模型里最灵活的:能改视频,也能把视频当输入。Veo 3.1 赢在 8 秒片段的画质和精确的末帧模式。Seedance 2.5 单次生成的片子最长。
怎么给 Gemini Omni 写提示词
- 生成时用和 Veo 一样的公式:镜头 + 主体 + 动作 + 环境 + 风格,声音另写。
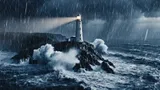
- 修改时一次只改一件事,并写明保留什么:“把天气改成晴天。保留镜头运动、构图和灯塔。”
- 用参考时写明每张图取什么:“第一个画面里的女孩,穿着第二张图的裙子,站在第三张图的阁楼里。”
- 迭代时先用 360p:按 Google 的说法,草稿最多快 60%,费用是 720p 的三分之一。
- 台词用英语更稳: 其他语言 Google 没有官方评估。
把这段视频的天气改成平静晴朗的夏日:干净的蓝天,
平静的碧海和细小波浪,白灯塔上的明亮阳光,悬崖上的绿草。
保留同样的镜头运动、构图和灯塔。声音:平静的海浪和海鸥,
代替风暴
如何在 AI2Face 里使用 Gemini Omni
- 打开生成器,选择视频和模型 Gemini Omni 1.1 Flash。
- 选择模式:按文字、按照片、按参考(最多 6 张图),或按首帧和尾帧。
- 设定时长(4、6、8 或 10 秒)、画幅(16:9 或 9:16)和分辨率。
- 开始生成——费用事先显示。
修改成片和延长都在 AI2Face 生成器里。Nano Banana 2 或 Seedream 的图可以直接当作片段的第一帧。Omni 在 AI2Face 生成器里可用,费用在生成前就能看到。
限制
- 语言。 完整支持的是英语,其他语言 Google 没有评估。
- 声音。 不能修改人声,API 目前也不支持音频参考。
- 延长对白。 不能把一段有人说话的上传视频延长,再补上新台词。
- 复杂运动和文字。 在模型卡里,Google 把修改时的完全一致、复杂动态和画面中准确的文字列为难点。
- 地区。 在欧洲经济区、瑞士和英国,不能存储和编辑视频。
- 标记。 所有片段都含 SynthID;可以在 Gemini 应用、Chrome 和 Google 搜索里核对此标记。
结论
Gemini Omni 是 Google 的日常视频模型:输入灵活,带声音,最重要的是能用普通句子修改成片。适合用照片和参考做片子、做教育场景、做快速迭代。要 8 秒片段的最高画质和精确落到末帧,选 Veo 3.1;要一次生成的长故事,选 Seedance 2.5。在 AI2Face,Omni 和图像模型在一起:生成器里的一帧可以直接成为视频的第一帧。
常见问题
Gemini Omni 是什么?
Google DeepMind 的视频模型,能用文字、图像和视频的任意组合生成片段,再用普通句子修改。家族的第一版是 Gemini Omni Flash,当前版是 Omni 1.1 Flash。
Gemini Omni 和 Veo 3.1 有什么不同?
Omni 接受的输入类型更多,还能用对话修改成片;Veo 3.1 则给出短片的最高画质。Google 建议把 Omni 当作默认视频模型,把 Veo 用于延长场景、末帧模式和旧流程。
Gemini Omni 能做多少秒视频?
单次 3 到 10 秒。成片可以每次延长 10 秒,直到 40 秒。在 AI2Face 里可选 4、6、8 和 10 秒。
它能理解英语以外的语言吗?
Google 只完整记录了英语,其他语言没有官方评估。对白用英语更稳。其他语言的提示词通常能懂,我们测试里的俄语提示词也是如此。
Gemini Omni 的官网在哪里?
没有单独的网站。官方渠道是 Gemini 应用、YouTube Shorts 和 YouTube Create、Google AI Studio,以及 Gemini API。名称里带 “omni” 的域名属于第三方服务。
可以免费试用 Gemini Omni 吗?
在 Google 这边,YouTube Shorts 和 YouTube Create 免费;Gemini 应用需要 Google AI Plus、Pro 或 Ultra 订阅。在 AI2Face,Omni 在生成器里按积分使用,费用在生成前就能看到。注册后会给到起始积分。
资料来源
6
- https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni/
- https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash/
- https://ai.google.dev/gemini-api/docs/omni
- https://deepmind.google/models/model-cards/gemini-omni-flash/
- https://ai.google.dev/gemini-api/docs/veo
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5