Datos clave
| Desarrollador | Google DeepMind |
|---|---|
| Fecha de salida | Anuncio — mayo de 2026 (Google I/O); Omni 1.1 Flash — 27 de agosto de 2026 |
| Qué hace | Crea y edita vídeo con sonido a partir de texto, imágenes y vídeo |
| Duración | 3–10 segundos por generación, extensión de 10 en 10 segundos hasta 40 |
| Resolución | 360p, 720p; 1080p y 4K por escalado; 24 fotogramas por segundo |
| Formatos de cuadro | 16:9 y 9:16 |
| Referencias | Imágenes y hasta 3 vídeos de 3 segundos |
| Sonido | Se genera junto con el vídeo |
| Marcado | Marca de agua invisible SynthID |
| En AI2Face | Sí, Omni 1.1 Flash en el generador |
Qué es Gemini Omni
Gemini Omni es una familia de modelos de Google DeepMind que crean contenido a partir de cualquier entrada. El vídeo fue lo primero. Google mostró el modelo en el I/O de mayo de 2026 y lo describió así: «imagina Nano Banana, pero para vídeo»: puedes retocar el resultado en cualquier paso con frases normales.
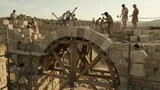
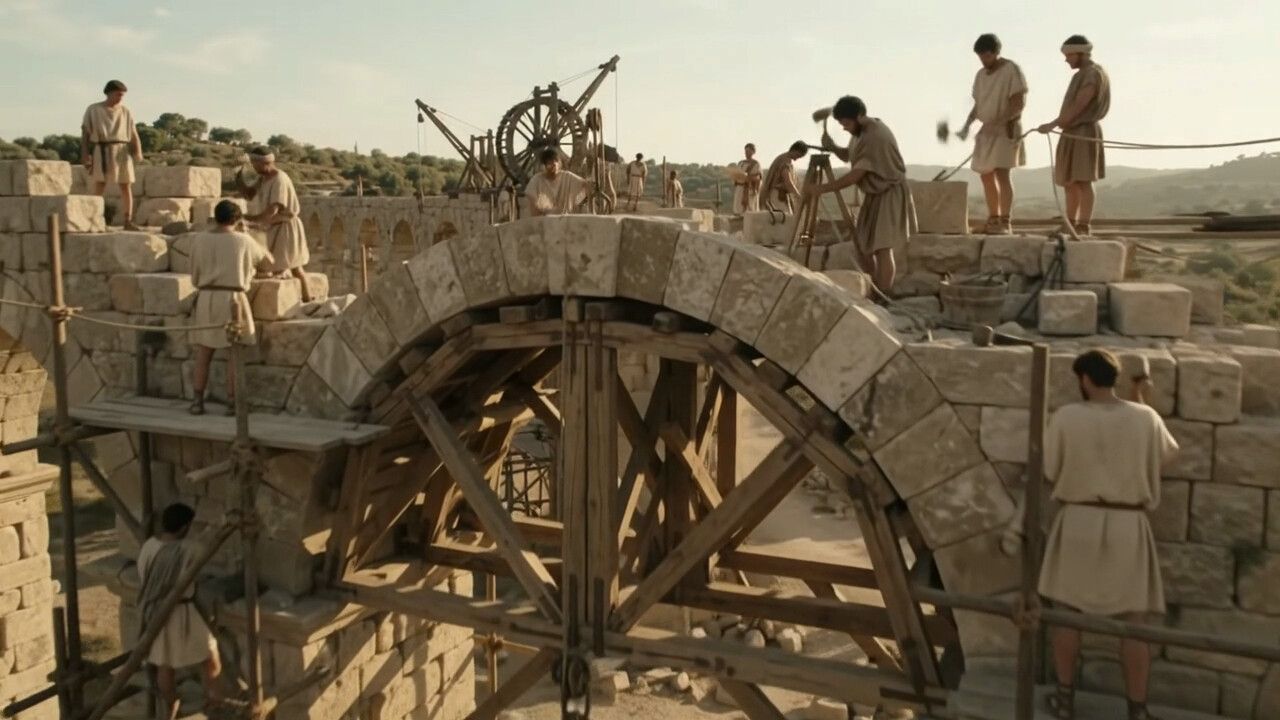
Omni se apoya en lo que Gemini sabe del mundo: física, historia, ciencia y cultura. Por eso una escena como «construcción de un acueducto en el siglo I» o «cómo funciona una esclusa» sale con detalles creíbles, no solo bonita.
El 27 de agosto de 2026 salió Omni 1.1 Flash, una versión estable con extensión de escenas, control del primer y último fotograma, borradores en 360p y salida hasta 4K. En la documentación de la Gemini API, Google la recomienda como modelo de vídeo por defecto, y Veo 3.1 para tareas concretas.
Qué sabe hacer Gemini Omni
Conocimiento del mundo. El modelo rellena detalles histórica y físicamente creíbles si pides una escena de un contexto real.
Una escena a partir de varias referencias. La protagonista de una foto, el vestido de otra, el loft de una tercera: Omni los junta en un clip y mantiene el aspecto.
Edición de un clip terminado. La diferencia principal con Veo: sube un vídeo y describe el cambio — tiempo, ropa, luz, objetos, movimiento de cámara. Cada edición siguiente se apoya en la anterior.
Primer y último fotograma. Dos imágenes, y el modelo construye la transición entre ellas con sonido.
Animar una foto. La imagen se vuelve el primer fotograma del clip: humo, gotas, movimiento de cámara.
Extensión. En la API el clip se extiende en pasos de 10 segundos hasta 40, y el modelo tiene en cuenta hasta 10 segundos del vídeo anterior, no solo el último fotograma.
Para qué sirve Gemini Omni
- Editar clips ya hechos: cambia el tiempo, la hora del día o la ropa, o quita un objeto, sin volver a rodar.
- Escenas educativas e históricas, donde importa que el detalle sea creíble.
- Anuncios a partir de una foto de producto: el objeto se convierte en un clip corto.
- Clips verticales cortos para redes, con sonido.
- Iteraciones rápidas: un borrador en 360p y el final en 1080p o 4K.
Gemini Omni y alternativas
| Gemini Omni 1.1 Flash | Veo 3.1 | Seedance 2.5 | |
|---|---|---|---|
| Desarrollador | Google DeepMind | Google DeepMind | ByteDance Seed |
| Duración por generación | 3–10 s | 4, 6, 8 s | hasta 30 s |
| Extensión | hasta 40 s | hasta 148 s (API, 720p) | 2 veces |
| Resolución | hasta 4K (escalado) | hasta 4K | no se publica |
| Entradas | texto, imágenes, vídeo | texto, hasta 3 imágenes | texto, 30 fotos, 10 vídeos, 10 audios |
| Edición de vídeo terminado | sí, con frases | no | sí |
| Idiomas de la voz | del todo — inglés | no publicados | no publicados |
| En AI2Face | sí | sí | sí |
Omni es el más flexible de los modelos de Google: edita vídeo y acepta vídeo de entrada. Veo 3.1 gana en la calidad de un clip de 8 segundos y en un modo preciso de último fotograma. Seedance 2.5 hace los clips más largos en una sola generación.
Cómo escribir prompts para Gemini Omni
- Para generar — la misma fórmula que para Veo: cámara + sujeto + acción + entorno + estilo, y el sonido aparte.
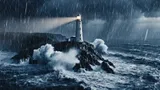
- Para editar — un cambio cada vez, y di qué conservar: «Cambia el tiempo a un día soleado. Conserva el movimiento de cámara, la composición y el faro».
- Para las referencias — di qué tomar de cada imagen: «la chica de la primera imagen con el vestido de la segunda, en el loft de la tercera».
- Para iterar — empieza en 360p: según Google, el borrador se genera hasta un 60 % más rápido y cuesta tres veces menos que 720p.
- Las réplicas son más fiables en inglés: Google no ha evaluado oficialmente el resto de idiomas.
Cambia el tiempo de este vídeo a un día de verano soleado y en calma: cielo azul despejado,
mar turquesa tranquilo con olas pequeñas, sol brillante sobre el faro blanco y hierba verde
en el acantilado. Conserva el mismo movimiento de cámara, la composición y el faro. Sonido: olas tranquilas y gaviotas
en lugar de la tormenta
Cómo usar Gemini Omni en AI2Face
- Abre el generador, elige vídeo y el modelo Gemini Omni 1.1 Flash.
- Elige el modo: por texto, por foto, por referencias (hasta 6 imágenes) o por primer y último fotograma.
- Indica la duración (4, 6, 8 o 10 segundos), el formato (16:9 o 9:16) y la resolución.
- Lanza la generación: el coste se ve antes.
La edición de un vídeo terminado y la extensión están en el generador de AI2Face. Una imagen de Nano Banana 2 o de Seedream puede entrar directamente como primer fotograma. Omni está en el generador de AI2Face, y el coste se ve antes de generar.
Límites
- Idiomas. Solo el inglés está admitido del todo; Google no ha evaluado el resto.
- Sonido. No puedes editar la voz, y las referencias de audio aún no están en la API.
- Extender con voz. No puedes extender un vídeo subido en el que habla una persona para añadir réplicas nuevas.
- Movimiento complejo y texto. En la ficha del modelo, Google señala como dificultades la coherencia total al editar, la dinámica compleja y el texto preciso en el cuadro.
- Regiones. Guardar y editar vídeo no está disponible en el EEE, Suiza y el Reino Unido.
- Marcado. Todos los clips llevan SynthID; puedes comprobar la marca en la app Gemini, en Chrome y en la Búsqueda de Google.
Conclusiones
Gemini Omni es el modelo de vídeo de Google para el día a día: flexible en las entradas, con sonido y, sobre todo, con edición de un clip terminado mediante frases normales. Úsalo para clips a partir de fotos y referencias, escenas educativas e iteraciones rápidas. Para la máxima calidad de un clip de 8 segundos y un paso preciso al último fotograma, elige Veo 3.1; para historias largas en una sola generación, Seedance 2.5. En AI2Face, Omni está junto a los modelos de imagen: un fotograma del generador se convierte al momento en el primer fotograma del vídeo.
Preguntas frecuentes
¿Qué es Gemini Omni?
Un modelo de vídeo de Google DeepMind que crea un clip a partir de cualquier combinación de texto, imágenes y vídeo, y lo edita con frases normales. La primera versión de la familia es Gemini Omni Flash; la actual es Omni 1.1 Flash.
¿En qué se diferencia Gemini Omni de Veo 3.1?
Omni acepta más tipos de entrada y sabe editar un clip terminado en diálogo, mientras que Veo 3.1 da la máxima calidad de un clip corto. Google recomienda Omni como modelo de vídeo por defecto, y Veo para extender escenas, el modo con último fotograma y los flujos antiguos.
¿Cuántos segundos de vídeo hace Gemini Omni?
De 3 a 10 segundos en una generación. Puedes extender el clip de 10 en 10 segundos hasta 40. En AI2Face están disponibles 4, 6, 8 y 10 segundos.
¿Entiende idiomas distintos del inglés?
Google documenta del todo solo el inglés; el resto de idiomas no está evaluado de forma oficial. El diálogo es más fiable en inglés. Los prompts en otros idiomas, incluidos los rusos de nuestras pruebas, suelen entenderse.
¿Dónde está el sitio oficial de Gemini Omni?
No hay un sitio aparte. Oficialmente Gemini Omni funciona en la app Gemini, en YouTube Shorts y YouTube Create, en Google AI Studio y por la Gemini API. Los dominios con “omni” en el nombre pertenecen a servicios de terceros.
¿Puedes probar Gemini Omni gratis?
En Google — gratis en YouTube Shorts y YouTube Create; en la app Gemini, con una suscripción Google AI Plus, Pro o Ultra. En AI2Face, Omni está en el generador con créditos, y el coste se ve antes de generar. Los de bienvenida se añaden al registrarte.
Fuentes
6
- https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni/
- https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash/
- https://ai.google.dev/gemini-api/docs/omni
- https://deepmind.google/models/model-cards/gemini-omni-flash/
- https://ai.google.dev/gemini-api/docs/veo
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5