Fakta utama
| Pengembang | Google DeepMind |
|---|---|
| Tanggal rilis | Pengumuman — Mei 2026 (Google I/O); Omni 1.1 Flash — 27 Agustus 2026 |
| Yang dilakukan | Membuat dan menyunting video bersuara dari teks, gambar, dan video |
| Durasi | 3–10 detik per generasi, perpanjangan 10 detik hingga 40 detik |
| Resolusi | 360p, 720p; 1080p dan 4K lewat upscale; 24 bingkai per detik |
| Format bingkai | 16:9 dan 9:16 |
| Referensi | Gambar dan hingga 3 video masing-masing 3 detik |
| Suara | Dihasilkan bersama video |
| Penandaan | Tanda air tak terlihat SynthID |
| Di AI2Face | Ya, Omni 1.1 Flash di generator |
Apa itu Gemini Omni
Gemini Omni adalah keluarga model Google DeepMind yang membuat konten dari masukan apa pun. Video yang muncul lebih dulu. Google menampilkan model ini di I/O pada Mei 2026 dan menggambarkannya begini: “bayangkan Nano Banana, tetapi untuk video” — hasilnya bisa diperhalus di langkah mana pun dengan kalimat biasa.
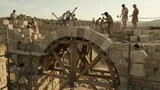
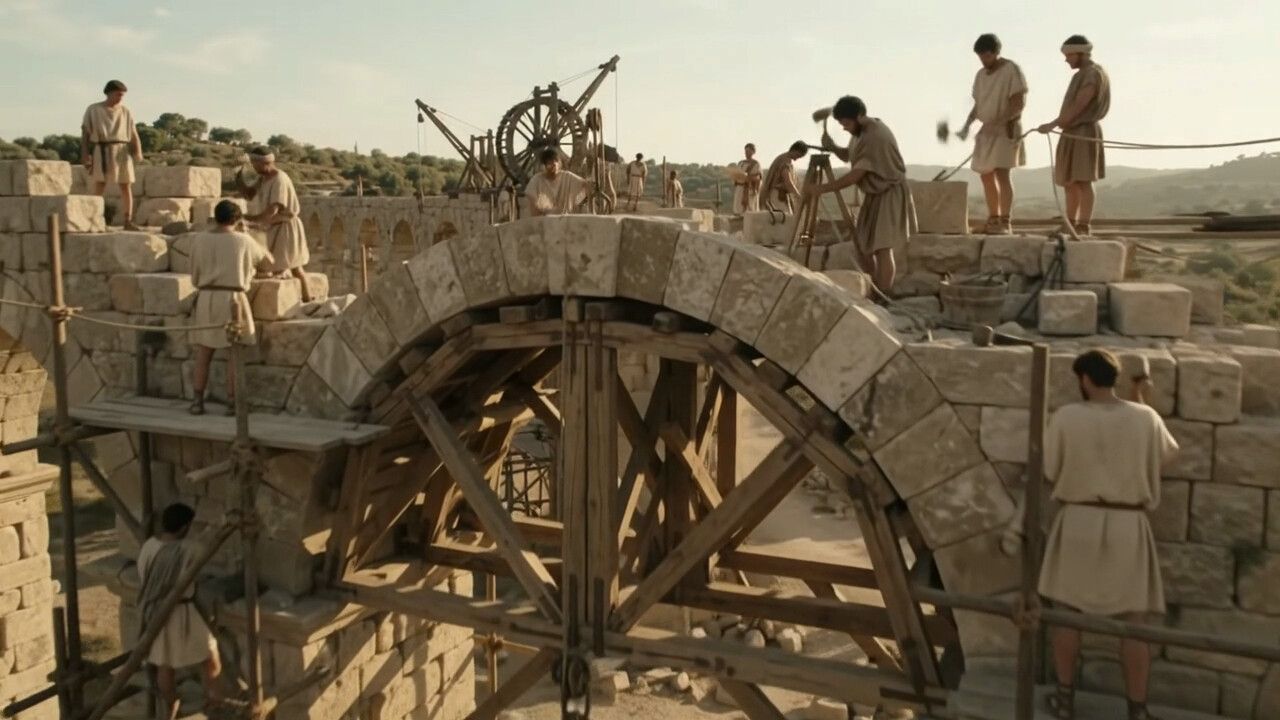
Omni bertumpu pada pengetahuan Gemini tentang dunia: fisika, sejarah, sains, dan budaya. Karena itu adegan seperti “pembangunan akuaduk pada abad ke-1” atau “cara kerja pintu air kanal” keluar dengan detail yang masuk akal, bukan hanya indah.
Pada 27 Agustus 2026 keluar Omni 1.1 Flash — versi stabil dengan perpanjangan adegan, kendali bingkai pertama dan terakhir, draf 360p, dan keluaran hingga 4K. Dalam dokumentasi Gemini API, Google merekomendasikannya sebagai model video bawaan, dan Veo 3.1 untuk tugas tertentu.
Apa yang Gemini Omni bisa lakukan
Pengetahuan dunia. Model mengisi detail yang masuk akal secara sejarah dan fisika kalau adegan diminta dari konteks nyata.
Adegan dari beberapa referensi. Tokoh dari satu foto, gaun dari foto lain, loteng dari yang ketiga — Omni menyatukannya dalam satu klip dan menjaga penampilan.
Suntingan klip jadi. Beda utama dari Veo: unggah video dan jelaskan perubahannya — cuaca, pakaian, cahaya, objek, gerak kamera. Setiap suntingan berikutnya dibangun di atas yang sebelumnya.
Bingkai pertama dan terakhir. Dua gambar, dan model membangun transisi di antaranya beserta suara.
Menghidupkan foto. Gambar menjadi bingkai pertama klip: asap, tetesan, gerak kamera.
Perpanjangan. Di API, klip diperpanjang bertahap 10 detik hingga 40 detik, dan model memperhitungkan hingga 10 detik video sebelumnya, bukan hanya bingkai terakhir.
Gemini Omni cocok untuk tugas apa
- Menyunting klip jadi: ganti cuaca, waktu, atau pakaian, atau hilangkan objek, tanpa syuting ulang.
- Adegan edukasi dan sejarah, yang detailnya harus masuk akal.
- Iklan dari foto produk: bidikan benda menjadi klip pendek.
- Klip vertikal pendek untuk jejaring, dengan suara.
- Iterasi cepat: draf di 360p, hasil akhir di 1080p atau 4K.
Gemini Omni dan alternatifnya
| Gemini Omni 1.1 Flash | Veo 3.1 | Seedance 2.5 | |
|---|---|---|---|
| Pengembang | Google DeepMind | Google DeepMind | ByteDance Seed |
| Durasi per generasi | 3–10 dtk | 4, 6, 8 dtk | hingga 30 dtk |
| Perpanjangan | hingga 40 dtk | hingga 148 dtk (API, 720p) | 2 kali |
| Resolusi | hingga 4K (upscale) | hingga 4K | tidak diungkapkan |
| Masukan | teks, gambar, video | teks, hingga 3 gambar | teks, 30 foto, 10 video, 10 audio |
| Menyunting video jadi | ya, dengan kalimat | tidak | ya |
| Bahasa ucapan | penuh — Inggris | tidak dipublikasikan | tidak dipublikasikan |
| Di AI2Face | ya | ya | ya |
Omni adalah yang paling luwes di antara model Google: menyunting video dan menerima video sebagai masukan. Veo 3.1 unggul pada kualitas klip 8 detik dan mode bingkai terakhir yang presisi. Seedance 2.5 membuat klip terpanjang dalam satu generasi.
Cara menulis prompt untuk Gemini Omni
- Untuk generasi — rumus yang sama dengan Veo: kamera + subjek + aksi + lingkungan + gaya, suara ditulis terpisah.
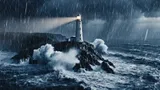
- Untuk suntingan — satu perubahan setiap kali, dan sebutkan apa yang dipertahankan: “Ganti cuaca menjadi hari cerah. Pertahankan gerak kamera, komposisi, dan mercusuar.”
- Untuk referensi — sebutkan apa yang diambil dari tiap gambar: “perempuan dari gambar pertama dengan gaun dari gambar kedua, di loteng dari gambar ketiga”.
- Untuk iterasi — mulai dari 360p: menurut Google, draf dibuat hingga 60% lebih cepat dan biayanya tiga kali lebih murah daripada 720p.
- Tulis dialog dalam bahasa Inggris kalau bisa: Google belum menilai bahasa lain secara resmi.
Ganti cuaca dalam video ini menjadi hari musim panas yang cerah dan tenang: langit biru bersih,
laut pirus yang tenang dengan ombak kecil, matahari terang di mercusuar putih dan rumput hijau
di tebing. Pertahankan gerak kamera, komposisi, dan mercusuar yang sama. Suara: ombak tenang dan camar
menggantikan badai
Cara memakai Gemini Omni di AI2Face
- Buka generator, pilih video dan model Gemini Omni 1.1 Flash.
- Pilih mode: dari teks, dari foto, dari referensi (hingga 6 gambar), atau dari bingkai pertama dan terakhir.
- Atur durasi (4, 6, 8, atau 10 detik), format (16:9 atau 9:16), dan resolusi.
- Mulai generasi — biaya terlihat sebelumnya.
Penyuntingan video jadi dan perpanjangan ada di generator AI2Face. Gambar dari Nano Banana 2 atau Seedream bisa langsung menjadi bingkai pertama klip. Omni tersedia di generator AI2Face, dan biayanya terlihat sebelum mulai membuat.
Batasan
- Bahasa. Bahasa Inggris didukung penuh; Google belum menilai bahasa lain.
- Suara. Suara tidak bisa disunting, dan referensi audio belum didukung di API.
- Memperpanjang ucapan. Video unggahan yang berisi orang berbicara tidak bisa diperpanjang untuk menambah dialog baru.
- Gerak rumit dan teks. Di kartu model, Google menyebut kesulitan pada konsistensi penuh saat menyunting, dinamika yang rumit, dan teks yang akurat di dalam bingkai.
- Wilayah. Menyimpan dan menyunting video tidak tersedia di EEA, Swiss, dan Britania Raya.
- Penandaan. Setiap klip memuat SynthID; tandanya bisa diperiksa di aplikasi Gemini, Chrome, dan Google Search.
Kesimpulan
Gemini Omni adalah model video Google untuk pemakaian sehari-hari: luwes pada masukan, dengan suara, dan yang utama — dengan suntingan klip jadi lewat kalimat biasa. Pakai untuk klip dari foto dan referensi, adegan edukasi, dan iterasi cepat. Untuk kualitas tertinggi klip 8 detik dan transisi yang presisi ke bingkai terakhir, pilih Veo 3.1; untuk cerita panjang dalam satu generasi, pilih Seedance 2.5. Di AI2Face, Omni tersedia bersama model gambar: bingkai dari generator langsung menjadi bingkai pertama video.
Pertanyaan umum
Apa itu Gemini Omni?
Model video Google DeepMind yang membuat klip dari campuran teks, gambar, dan video apa pun, lalu menyuntingnya dengan kalimat biasa. Versi pertama keluarga ini adalah Gemini Omni Flash; yang sekarang adalah Omni 1.1 Flash.
Apa beda Gemini Omni dengan Veo 3.1?
Omni menerima lebih banyak jenis masukan dan bisa menyunting klip jadi lewat dialog, sedangkan Veo 3.1 memberi kualitas tertinggi untuk klip pendek. Google menyarankan Omni sebagai model video bawaan, dan Veo untuk memperpanjang adegan, mode bingkai terakhir, serta pipeline lama.
Berapa detik video yang dibuat Gemini Omni?
Dari 3 sampai 10 detik dalam satu generasi. Klip bisa diperpanjang 10 detik sekali hingga 40 detik. Di AI2Face tersedia 4, 6, 8, dan 10 detik.
Apakah model ini memahami bahasa selain bahasa Inggris?
Google hanya mendokumentasikan bahasa Inggris secara penuh; bahasa lain tidak dinilai secara resmi. Dialog lebih andal dalam bahasa Inggris. Prompt dalam bahasa lain, termasuk yang berbahasa Rusia dalam pengujian kami, biasanya dipahami.
Di mana situs resmi Gemini Omni?
Tidak ada situs terpisah. Secara resmi Gemini Omni berjalan di aplikasi Gemini, di YouTube Shorts dan YouTube Create, di Google AI Studio, dan lewat Gemini API. Domain yang memuat “omni” pada namanya milik layanan pihak ketiga.
Bisakah mencoba Gemini Omni gratis?
Di Google — gratis di YouTube Shorts dan YouTube Create; di aplikasi Gemini, dengan langganan Google AI Plus, Pro, atau Ultra. Di AI2Face, Omni tersedia di generator dengan kredit, dan biayanya terlihat sebelum mulai membuat. Kredit sambutan masuk setelah mendaftar.
Sumber
6
- https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni/
- https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash/
- https://ai.google.dev/gemini-api/docs/omni
- https://deepmind.google/models/model-cards/gemini-omni-flash/
- https://ai.google.dev/gemini-api/docs/veo
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5