Fatos principais
| Desenvolvedor | Google DeepMind |
|---|---|
| Data de lançamento | Anúncio — maio de 2026 (Google I/O); Omni 1.1 Flash — 27 de agosto de 2026 |
| O que faz | Cria e edita vídeo com som a partir de texto, imagens e vídeo |
| Duração | 3–10 segundos por geração, extensão de 10 em 10 segundos até 40 segundos |
| Resolução | 360p, 720p; 1080p e 4K por upscale; 24 quadros por segundo |
| Formatos de quadro | 16:9 e 9:16 |
| Referências | Imagens e até 3 vídeos de 3 segundos |
| Som | Gerado junto com o vídeo |
| Marcação | Marca d'água invisível SynthID |
| No AI2Face | Sim, Omni 1.1 Flash no gerador |
O que é Gemini Omni
Gemini Omni é uma família de modelos do Google DeepMind que criam conteúdo a partir de qualquer entrada. O vídeo veio primeiro. O Google mostrou o modelo no I/O de maio de 2026 e o descreveu assim: “imagine o Nano Banana, mas para vídeo” — você pode refinar o resultado em qualquer passo com frases comuns.
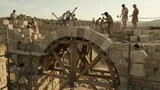
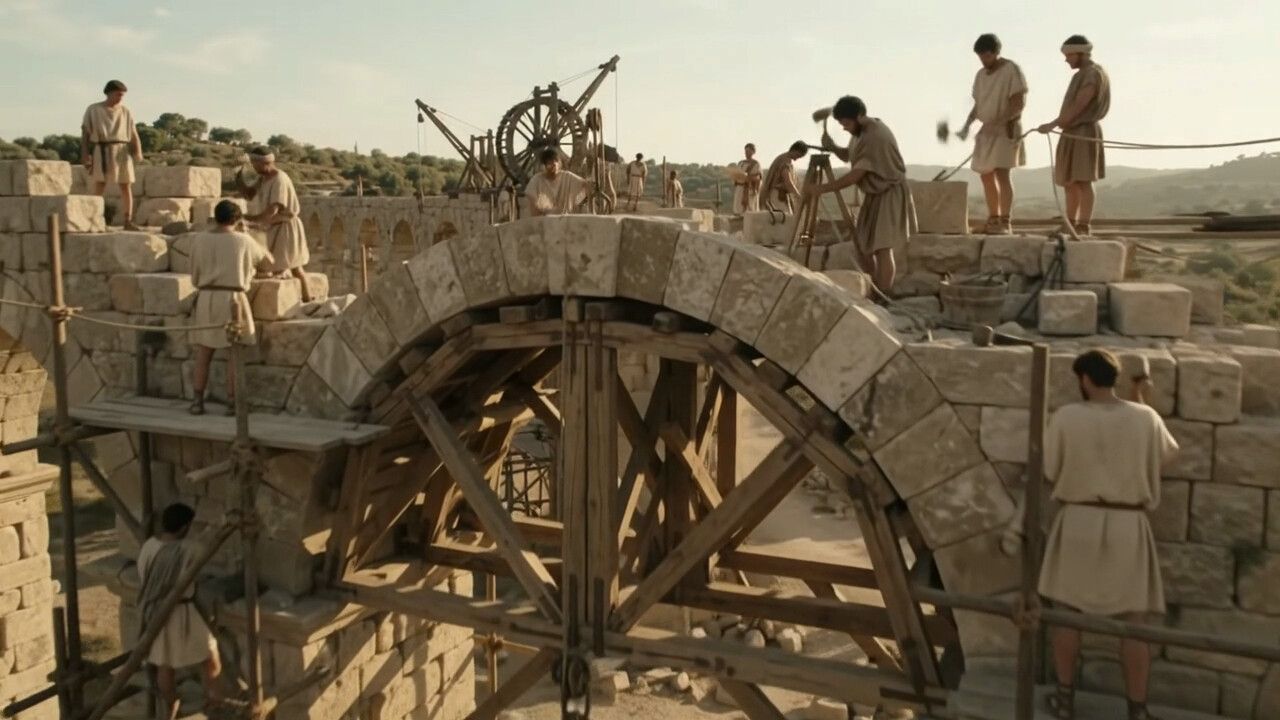
O Omni se apoia no que o Gemini sabe do mundo: física, história, ciência e cultura. Por isso uma cena como “construção de um aqueduto no século I” ou “como funciona uma eclusa” sai com detalhes plausíveis, não só bonita.
Em 27 de agosto de 2026 saiu o Omni 1.1 Flash — uma versão estável com extensão de cenas, controle do primeiro e do último quadro, rascunhos em 360p e saída até 4K. Na documentação da Gemini API, o Google o recomenda como modelo de vídeo padrão, e o Veo 3.1 para tarefas específicas.
O que o Gemini Omni faz
Conhecimento do mundo. O modelo completa detalhes histórica e fisicamente plausíveis quando você pede uma cena de um contexto real.
Uma cena a partir de várias referências. A personagem de uma foto, o vestido de outra, o loft de uma terceira — o Omni junta tudo num clipe e mantém a aparência.
Edição de um clipe pronto. A diferença principal em relação ao Veo: envie um vídeo e descreva a mudança — clima, roupa, luz, objetos, movimento de câmera. Cada edição seguinte se apoia na anterior.
Primeiro e último quadro. Duas imagens, e o modelo constrói a transição entre elas com som.
Animar uma foto. A imagem vira o primeiro quadro do clipe: fumaça, gotas, movimento de câmera.
Extensão. Na API o clipe se estende em passos de 10 segundos até 40 segundos, e o modelo leva em conta até 10 segundos do vídeo anterior, não só o último quadro.
Para que tarefas o Gemini Omni serve
- Editar clipes prontos: mude o clima, a hora do dia ou a roupa, ou tire um objeto, sem refilmar.
- Cenas educativas e históricas, em que o detalhe plausível importa.
- Anúncio a partir de uma foto de produto: o objeto vira um clipe curto.
- Clipes verticais curtos para redes, com som.
- Iterações rápidas: um rascunho em 360p, o final em 1080p ou 4K.
Gemini Omni e alternativas
| Gemini Omni 1.1 Flash | Veo 3.1 | Seedance 2.5 | |
|---|---|---|---|
| Desenvolvedor | Google DeepMind | Google DeepMind | ByteDance Seed |
| Duração por geração | 3–10 s | 4, 6, 8 s | até 30 s |
| Extensão | até 40 s | até 148 s (API, 720p) | 2 vezes |
| Resolução | até 4K (upscale) | até 4K | não divulgada |
| Entradas | texto, imagens, vídeo | texto, até 3 imagens | texto, 30 fotos, 10 vídeos, 10 áudios |
| Edição de vídeo pronto | sim, com frases | não | sim |
| Idiomas da fala | por completo — inglês | não publicados | não publicados |
| No AI2Face | sim | sim | sim |
O Omni é o mais flexível dos modelos do Google: edita vídeo e aceita vídeo na entrada. O Veo 3.1 ganha na qualidade de um clipe de 8 segundos e num modo preciso de último quadro. O Seedance 2.5 faz os clipes mais longos numa geração.
Como escrever prompts para o Gemini Omni
- Para gerar — a mesma fórmula do Veo: câmera + sujeito + ação + cenário + estilo, e o som à parte.
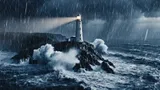
- Para editar — uma mudança de cada vez, e diga o que manter: “Mude o tempo para um dia de sol. Mantenha o movimento de câmera, a composição e o farol.”
- Para referências — diga o que tirar de cada imagem: “a mulher da primeira imagem no vestido da segunda, no loft da terceira”.
- Para iterar — comece em 360p: segundo o Google, um rascunho é gerado até 60% mais rápido e custa três vezes menos que 720p.
- Escreva as falas em inglês quando puder: o Google não avaliou oficialmente os outros idiomas.
Mude o tempo neste vídeo para um dia de verão ensolarado e calmo: céu azul limpo,
mar turquesa calmo com ondas pequenas, sol forte no farol branco e grama verde
no penhasco. Mantenha o mesmo movimento de câmera, a composição e o farol. Som: ondas calmas e gaivotas
no lugar da tempestade
Como usar o Gemini Omni no AI2Face
- Abra o gerador, escolha vídeo e o modelo Gemini Omni 1.1 Flash.
- Escolha um modo: por texto, por foto, por referências (até 6 imagens) ou por primeiro e último quadro.
- Defina a duração (4, 6, 8 ou 10 segundos), o formato (16:9 ou 9:16) e a resolução.
- Comece a geração — o custo aparece antes.
A edição de um vídeo pronto e a extensão estão no gerador do AI2Face. Uma imagem do Nano Banana 2 ou do Seedream pode entrar direto como primeiro quadro do clipe. O Omni está no gerador do AI2Face, e o custo aparece antes de você gerar.
Limitações
- Idiomas. O inglês tem suporte completo; o Google não avaliou os outros idiomas.
- Som. Você não pode editar a voz, e referências de áudio ainda não são aceitas na API.
- Estender fala. Você não pode estender um vídeo enviado em que uma pessoa fala para acrescentar falas novas.
- Movimento complexo e texto. No cartão do modelo, o Google aponta como dificuldades a coerência total nas edições, a dinâmica complexa e o texto preciso no quadro.
- Regiões. Armazenar e editar vídeo não está disponível no EEE, na Suíça e no Reino Unido.
- Marcação. Todo clipe contém SynthID; você pode conferir a marca no app Gemini, no Chrome e na Busca Google.
Conclusões
Gemini Omni é o modelo de vídeo do Google para o dia a dia: flexível nas entradas, com som e, principalmente, com a edição de um clipe pronto por frases comuns. Use-o para clipes a partir de fotos e referências, cenas educativas e iterações rápidas. Para a qualidade máxima de um clipe de 8 segundos e uma passagem precisa até o último quadro, escolha Veo 3.1; para histórias longas numa geração, Seedance 2.5. No AI2Face, o Omni está junto dos modelos de imagem: um quadro do gerador vira na hora o primeiro quadro do vídeo.
Perguntas frequentes
O que é Gemini Omni?
Um modelo de vídeo do Google DeepMind que cria um clipe a partir de qualquer combinação de texto, imagens e vídeo e o edita com frases comuns. A primeira versão da família é Gemini Omni Flash; a atual é Omni 1.1 Flash.
Em que Gemini Omni difere do Veo 3.1?
O Omni aceita mais tipos de entrada e sabe editar um clipe pronto em diálogo, enquanto o Veo 3.1 dá a qualidade máxima de um clipe curto. O Google recomenda o Omni como modelo de vídeo padrão, e o Veo para estender cenas, o modo com o último quadro e pipelines antigos.
Quantos segundos de vídeo o Gemini Omni faz?
De 3 a 10 segundos numa geração. Você pode estender um clipe de 10 em 10 segundos até 40 segundos. No AI2Face estão disponíveis 4, 6, 8 e 10 segundos.
Ele entende idiomas além do inglês?
O Google documenta por completo só o inglês; os outros idiomas não foram avaliados oficialmente. O diálogo é mais confiável em inglês. Prompts em outros idiomas, inclusive os em russo dos nossos testes, em geral são entendidos.
Onde fica o site oficial do Gemini Omni?
Não há um site separado. Oficialmente o Gemini Omni funciona no app Gemini, no YouTube Shorts e no YouTube Create, no Google AI Studio e pela Gemini API. Domínios com “omni” no nome pertencem a serviços de terceiros.
Dá para experimentar o Gemini Omni de graça?
No Google — de graça no YouTube Shorts e no YouTube Create; no app Gemini, com uma assinatura Google AI Plus, Pro ou Ultra. No AI2Face, o Omni está no gerador em créditos, e o custo aparece antes de você gerar. Os de boas-vindas entram depois do cadastro.
Fontes
6
- https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-omni/
- https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash/
- https://ai.google.dev/gemini-api/docs/omni
- https://deepmind.google/models/model-cards/gemini-omni-flash/
- https://ai.google.dev/gemini-api/docs/veo
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5