关键信息
| 开发者 | ByteDance Seed |
|---|---|
| 版本 | Seedance 2.5(2026年7月31日),Seedance 2.0 与 2.0 Fast(2026年2月12日) |
| 功能 | 根据文字、图像、视频和音频生成有声视频;可修改和延长成片 |
| 时长 | 2.5:单次最长 30 秒,并可延长两次;2.0:4–15 秒 |
| 参考 | 2.5:最多 30 张图、10 段视频、10 段音频;2.0:最多 9、3、3 |
| 分辨率 | 2.0 原生 480p 和 720p;2.5 的分辨率开发者未公布 |
| 声音 | 与画面一起生成:对白、音效、音乐 |
| 在哪里用 | Jimeng 和 Doubao Pro,以及面向开发者的 API |
| 在 AI2Face | 有 |
Seedance 是什么
Seedance 是 ByteDance Seed 团队的视频模型,同一团队还做图像模型 Seedream。这个家族的核心是同一套架构同时做画面和声音:片段、对白、音效和音乐一起生成,而不是事后拼上去。
Seedance 2.0 于 2026 年 2 月 12 日发布。它第一次同时接收四类输入——文字、图像、视频和音频——并学会修改和延长成片。更快的 Seedance 2.0 Fast 同时推出。
Seedance 2.5 于 2026 年 7 月 31 日在同一架构上发布。主要差别是长度:单次最长 30 秒,并可延长两次。模型在片段内部安排几个相连的镜头,而不是把一个瞬间拉长。
Seedance 能做什么
一次生成多个镜头。 按镜头写场景——全景、中景、跟拍——模型会把它们收成一条带剪辑和统一声音的片子。
用参考锁定人物。 在 Seedance 2.5 里一次上传最多 30 张图、10 段视频和 10 段音频,并在提示词里写明各取什么。模型会在新场景里保住人物的脸和外形。
对白和声音。 引号里的台词会变成口型同步的语音,模型自己做两人之间的正反打。
动作和镜头运动。 模型能稳住快动作:运动、跳跃、无人机飞过、高潮处的慢放。
修改和延长。 Seedance 2.0 和 2.5 能改成片里的片段、人物、动作和情节。2.5 增加了按时间码修改、绿幕,以及用“白模”控制——场景的粗略三维块体。
Seedance 2.5 和 2.0:差别在哪
| Seedance 2.0 | Seedance 2.5 | |
|---|---|---|
| 发布 | 2026年2月12日 | 2026年7月31日 |
| 单次时长 | 4–15 秒 | 最长 30 秒 |
| 延长 | 可以 | 两次 |
| 参考 | 最多 9 张图、3 段视频、3 段音频 | 最多 30 张图、10 段视频、10 段音频 |
| 一次做出多个镜头 | 可以 | 可以,情节相连 |
| 修改 | 片段、人物、动作 | + 时间码、绿幕、“白模” |
| 加速版 | 2.0 Fast | — |
ByteDance 单独列出 2.5 的改进:物体纹理、皮肤和眼睛、光线、色彩饱和度,以及声音和画面的同步。
Seedance 适合什么任务
- 20–30 秒的短故事和广告,不用把几次生成拼在一起。
- 配乐短片: 把音频作为节奏和音色的参考上传。
- 同一主角的系列: 一次请求里放几十张人物照片。
- 运动和动作: 快速运动、飞越、慢放。
- 改已有成片: 按时间码替换人物、动作或一段。
Seedance 和同类模型
| Seedance 2.5 | Veo 3.1 | Gemini Omni 1.1 Flash | |
|---|---|---|---|
| 开发者 | ByteDance Seed | Google DeepMind | Google DeepMind |
| 单次时长 | 最长 30 秒 | 4、6、8 秒 | 3–10 秒 |
| 延长 | 2 次 | 最长 148 秒(API,720p) | 最长 40 秒 |
| 分辨率 | 未公布 | 最高 4K | 最高 4K(放大) |
| 参考 | 30 张照片、10 段视频、10 段音频 | 最多 3 张图 | 图像,以及最多 3 段视频 |
| 声音 | 有 | 有 | 有 |
| 在 AI2Face | 有 | 有 | 有 |
Seedance 2.5 在单条时长和参考数量上领先。Veo 3.1 提供 4K 和精确的首尾帧模式。Gemini Omni Flash 快,输入也更灵活。
怎么给 Seedance 写提示词
- 声音写得和画面一样具体: 引号里的台词、音乐、关键音效。
- 多个镜头要编号: “镜头 1:全景……镜头 2:中景……镜头 3:跟拍……”。
- 参考按编号来叫。 ByteDance 官方示例是:“人物用 @Image 2,场景用 @Image 3,道具用 @Image 4”。
- 先用短片试想法,提示词定了再做长片:30 秒比 5 秒贵好几倍。
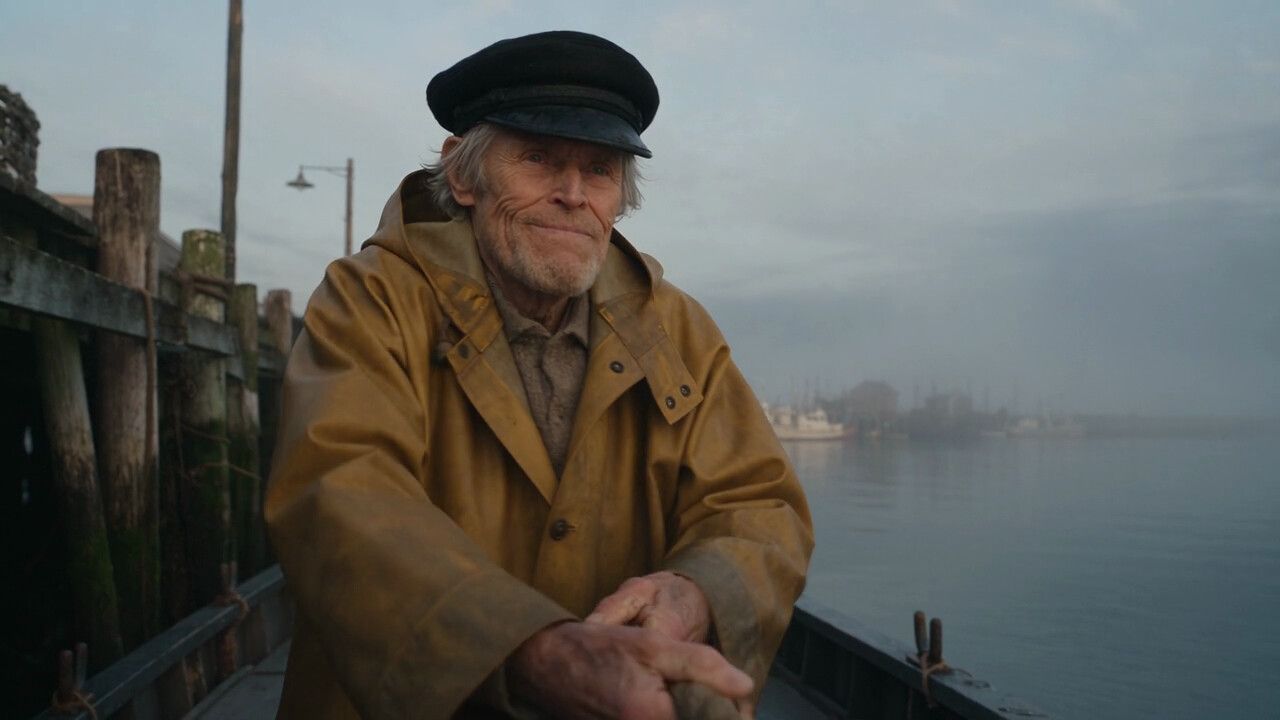
三个镜头的短故事。镜头 1:黎明时分渔村的全景,雾气
笼罩港口,船轻轻摇晃,海鸥叫。镜头 2:老渔夫的中景,
他穿着黄色雨衣,解开木船的缆绳,望向海面,微笑。
镜头 3:跟在船后,船离开港口,驶向金色的日出。声音:海浪、
木头吱呀、远处的海鸥、逐渐升起的弦乐。照片级真实,35 毫米胶片
如何在 AI2Face 里使用 Seedance
Seedance 在 AI2Face 生成器里:最长 30 秒的有声片段,以及参考图工作流。费用在开始前就能看到。
同一生成器里还有两个 Google 模型,用来做别的事:
- Veo 3.1 — 4–8 秒、最高 4K,带对白和音效,让照片动起来,最多 3 个参考,首帧和尾帧。
- Gemini Omni 1.1 Flash — 最长 10 秒,图像参考,首帧和尾帧。
如果要 4K,用同一人物的参考,把长故事拆成几段 8 秒的 Veo 3.1。两个 Google 模型的费用也在开始前显示。
限制
- 真人面孔。 用真人肖像做参考时,ByteDance 要求身份核验或法律授权。
- 复杂物理和多个人物。 ByteDance 自己也承认:复杂动作的物理可信度,以及多个人物互动场面的稳定性,还需要改进。
- 细节和文字。 在 Seedance 2.0 的评测里,开发者指出细节不稳定、偶发的声音失真,以及画面中文字不准确。
- 可用性。 官方在中国应用 Jimeng 和 Doubao Pro 里提供,也通过面向开发者的 API 提供。2.5 发布时,它的 API 状态是“即将推出”。
结论
Seedance 2.5 适合做长叙事片段:一次生成 30 秒有声视频,再加上几十个参考,目前还没有竞品能同时做到。Seedance 2.0 仍然适合 15 秒以内、需要修改的片子。Seedance 可在 AI2Face 使用。如果要 4K,或两帧之间的精确过渡,用同一生成器里的 Veo 3.1。Veo 上的长故事由几段 8 秒、同一人物的场景拼成。
常见问题
Seedance 是什么?
ByteDance Seed 团队的视频模型家族,该团队也做 TikTok 和 CapCut。Seedance 根据文字和参考(照片、视频、音频)生成带声音的片段。
Seedance 2.5 和 2.0 有什么不同?
Seedance 2.5 单次最长 30 秒,而不是 15 秒;参考最多 50 个,而不是 15 个;一次生成里能做出几个相连的镜头。物体纹理、皮肤、光线和声音同步也更好。
Seedance 能做多少秒视频?
Seedance 2.5 单次最长 30 秒,成片还可以再延长两次。Seedance 2.0 是 4 到 15 秒。
AI2Face 里有 Seedance 吗?
有。Seedance 在 AI2Face 生成器里可用,费用在生成前就能看到。同一生成器里还有 Veo 3.1 和 Gemini Omni Flash,用来做 4K 以及首尾帧。
可以把自己的脸上传到 Seedance 吗?
有限制。如果参考是真人肖像,ByteDance 要求身份核验或法律授权。
资料来源
6
- https://seed.bytedance.com/en/blog/one-take-creation-flexible-referencing-introducing-seedance-2-5
- https://seed.bytedance.com/en/seedance2_5
- https://seed.bytedance.com/en/blog/official-launch-of-seedance-2-0
- https://seed.bytedance.com/en/public_papers/seedance-2-0-advancing-video-generation-for-world-complexity
- https://ai.google.dev/gemini-api/docs/veo
- https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash/