فيديو القبلة من صورة من أكثر اتجاهات الفيديو القصير رواجًا: يصنعه الأزواج في ذكرى زواجهم، والأصدقاء للمزاح، وصنّاع المحتوى لشخصيات الذكاء الاصطناعي. تقدّم التطبيقات الجاهزة قالب قبلة بضغطة واحدة، بينما يتيح لك نموذج فيديو بالمراجع تصوير مشهدك الخاص — المكان والضوء وحركة الكاميرا والصوت. صوّرنا قبلة وعناقًا ورقصة مع ثنائي خيالي. كل الصور والمقاطع أُنشئت في مولّد AI2Face، والأشخاص فيها مختلَقون.
كيف يُصنع فيديو قبلة بالذكاء الاصطناعي
هناك نوعان من المدخلات وطريقتان للتحكم في المشهد.
| تأثير قالب في تطبيق | برومبت خاص بك في نموذج فيديو | |
|---|---|---|
| ما ترفعه | صورة واحدة للثنائي أو صورتان | صورة واحدة للثنائي أو صورتان شخصيتان منفصلتان |
| المشهد | نفسه كما في الصورة | أي مشهد: جسر أو محطة أو مطبخ أو مطر |
| الحركة | واحدة لكل قالب | أنت تصفها: الاقتراب، قبلة على الجبين، دوران |
| الصوت | موسيقى القالب أو لا شيء | يُولَّد للمشهد: نهر أو محطة أو أغنية |
| ما يغيّر النتيجة | القالب الذي تختاره فقط | كل كلمة في البرومبت |
صورة واحدة للثنائي تصبح الإطار الأول: يبدأ المقطع من لقطتك تمامًا. صورتان شخصيتان منفصلتان تعملان كمرجعين: يضع النموذج الشخصين بنفسه في مشهد جديد. الطريقة الثانية لمن لا يملك صورة تجمعهما — كتهنئة عن بُعد مثلًا، أو لثنائي من شخصيات الذكاء الاصطناعي.
كيف تصنع فيديو قبلة من صورتين
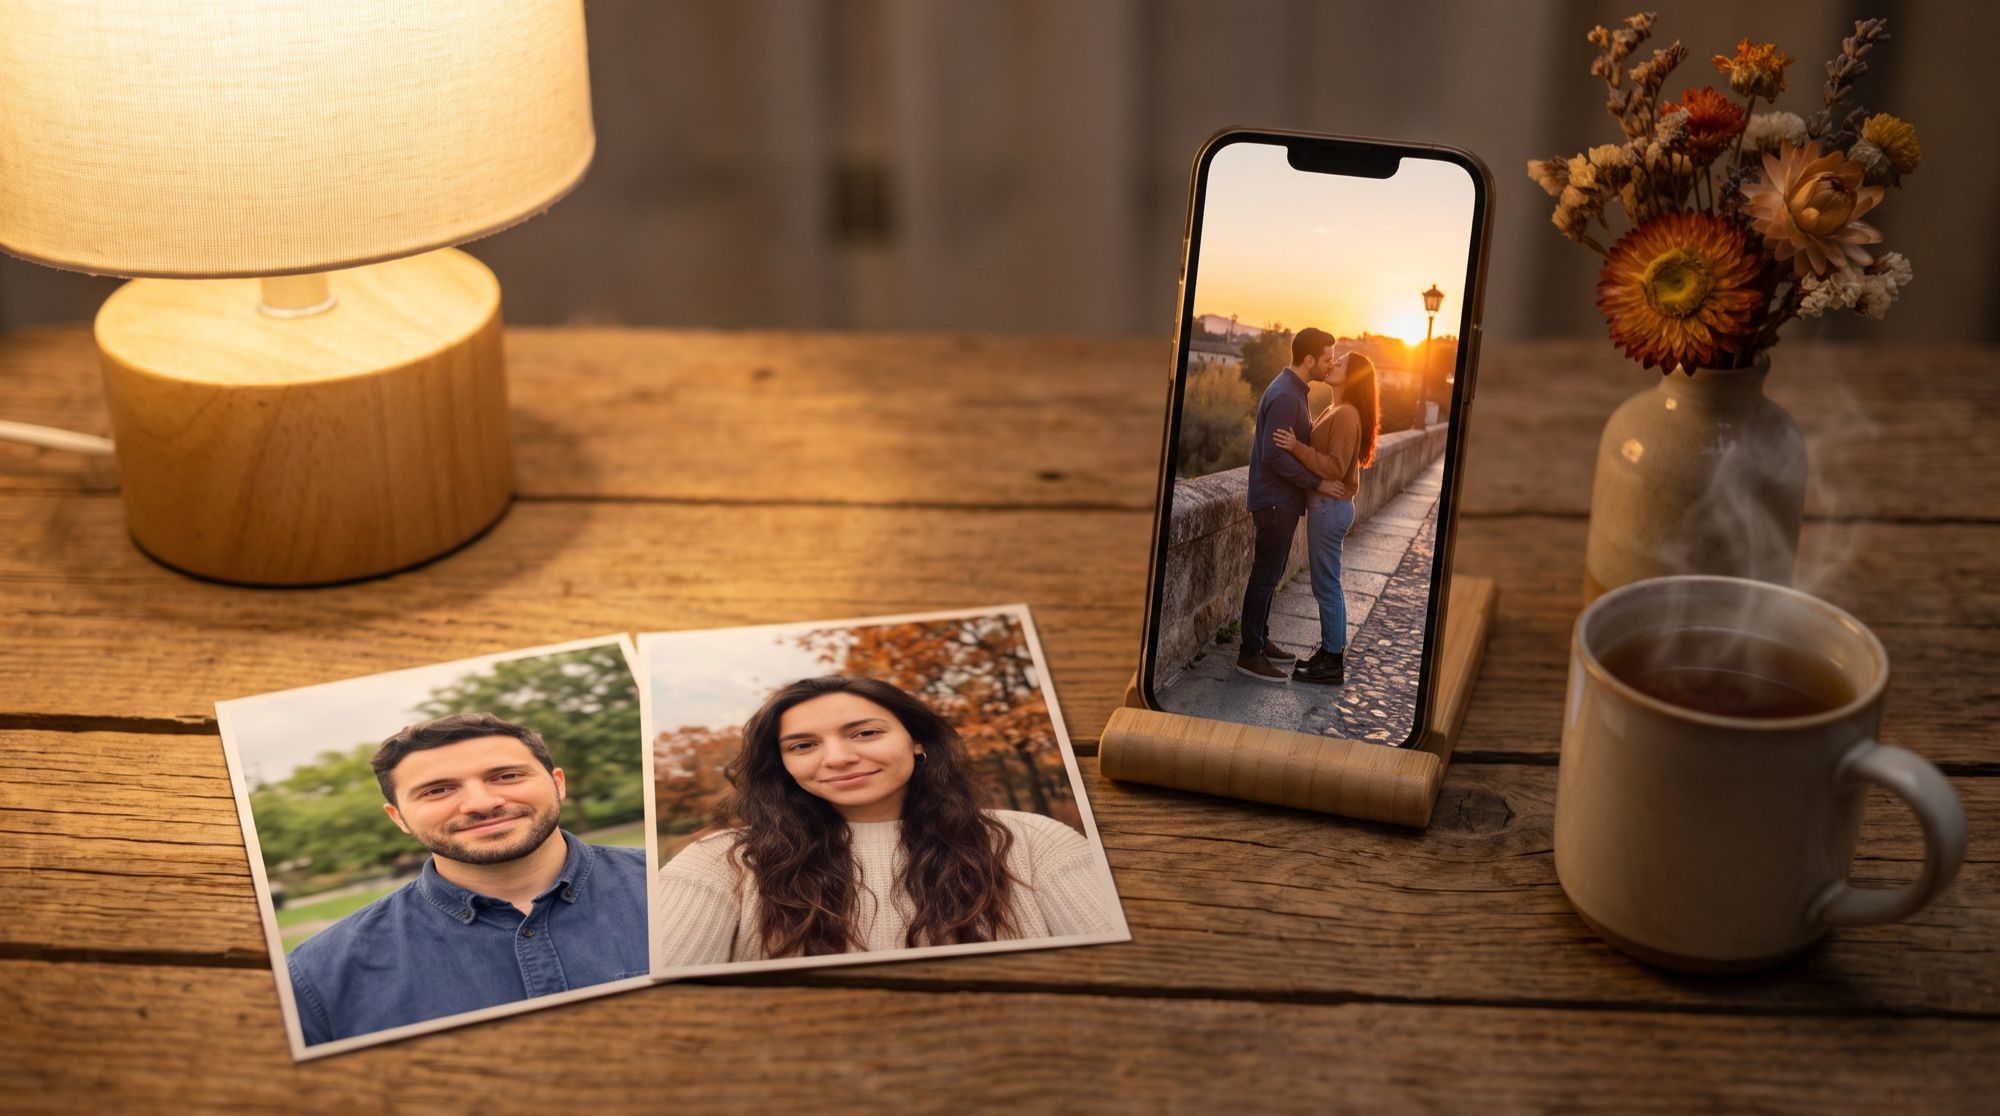
أخذنا صورتين شخصيتين منفصلتين: رجل بقميص جينز في حديقة، وامرأة بسترة كريمية أمام أشجار الخريف.
دخلت الصورتان كمرجعين إلى Gemini Omni. يذكر البرومبت من يأتي من أي صورة، وماذا يرتديان، وأين يقفان، وكيف تتحرك الكاميرا:
Romantic vertical video at golden hour: the man from the first reference photo
(short dark wavy hair, short beard, navy denim shirt) and the woman from the
second reference photo (long dark-brown wavy hair, silver hoop earrings, cream
knit sweater) stand facing each other on an old stone bridge over a river at
sunset. She smiles, he gently tucks a strand of hair behind her ear, they lean in
and share a soft, tender kiss, then rest their foreheads together and smile.
Slow push-in, medium close-up, warm backlight, light breeze. Keep both faces
exactly as in the photos. Sound: river, distant city, soft wind. No text.
أدّى النموذج كل خطوة من المشهد بالترتيب: الابتسامة، وخصلة الشعر، والقبلة، والجبين على الجبين. الوجوه والملابس تطابق الصورتين، وأقراطها ما زالت في مكانها. أما ضوء الغروب فوضعه النموذج بنفسه — فقد التُقطت الصورتان الأصليتان في يوم غائم.
فيديو عناق بالذكاء الاصطناعي من الصور
يُصنع العناق بالطريقة نفسها — يتغير الحدث فقط. وضعنا الثنائي على رصيف قطار: تراه، وتركض إليه، فيرفعها ويدوّر بها. الصوت هو أجواء المحطة فقط: منعنا الضحك والأصوات في سطر مستقل من البرومبت.
Vertical video of a reunion at a train station platform in the morning: the
woman from the second reference photo (long dark-brown wavy hair, cream knit
sweater) sees the man from the first reference photo (short dark wavy hair,
short beard, navy denim shirt, a travel bag on his shoulder), runs to him, and
they hug tightly; he lifts her slightly off the ground and spins half a turn,
both smiling, her eyes closed on his shoulder. Handheld camera, medium shot,
soft morning light, a blurred train behind them. Keep both faces exactly as in
the photos. Sound: only station ambience — footsteps, a distant train, soft
murmur of the platform. No laughter, no voices, no speech. No text, no readable
signs.
خرج العناق أكثر حيوية من القبلة: ركض وابتسامات ونصف دورة. أضاف النموذج الحقيبة على الكتف كما طلبنا، وأبقى لافتة الرصيف ضبابية بلا نص مقروء. صِف الصوت صراحةً، بما في ذلك ما لا يجب أن يظهر: «No laughter, no voices».
فيديو رقص بالذكاء الاصطناعي من صورة للثنائي
إذا كانت لديك صورة تجمعكما، فاجعلها الإطار الأول وسيبدأ المقطع من لقطتك تمامًا. جمعنا صورة الثنائي من الصورتين الشخصيتين نفسيهما في Nano Banana Pro — بالطريقة التي تُبنى بها صورة ثنائي من لقطتين في دليلنا عن دمج الصور بالذكاء الاصطناعي.
The couple starts a slow dance in their cozy kitchen: he takes her hand, she
laughs, he gently spins her under his arm and pulls her close, they sway together
cheek to cheek under the warm string lights. Static camera at chest height, smooth
natural motion. Keep both faces, hair and clothes exactly as in the image.
Sound: a soft acoustic love song playing from a speaker, her quiet laugh. No text.
أدّى النموذج الرقصة البطيئة بدورة واحدة بسلاسة — بلا أيدٍ زائدة ولا حركات مطاطية. الرقصات السريعة بالرفعات والقفزات أصعب على نماذج الفيديو: اجعل الحركات بسيطة والمقاطع قصيرة.
برومبتات القبلة: 6 مشاهد جاهزة
صيغة البرومبت: من (من أي صورة، أبرز الملامح) + أين (المكان ووقت اليوم والضوء) + الحدث خطوة بخطوة + الكاميرا + الصوت. تندرج المشاهد أدناه في هذه الصيغة. استبدل الملامح بملامح من تستخدمهم.
قبلة تحت المطر.
The couple stands under one umbrella on a night city street, he lowers the
umbrella, they kiss in the rain, raindrops in the warm street light. Slow
motion, medium close-up. Sound: heavy rain, distant traffic.
قبلة على الجبين.
The man gently holds the woman's face in his hands and kisses her on the
forehead, she closes her eyes and smiles. Soft window light in a quiet bedroom,
close-up. Sound: quiet room tone, a soft breath.
دوران ثم قبلة.
On a sunny beach the man lifts the woman and spins her around, puts her down and
kisses her, both laughing. Low-angle handheld camera. Sound: waves, wind, their
laughter.
قبلة على الخد.
In a busy café the woman leans across the table and kisses the man on the cheek,
he blushes and laughs. Static camera, medium shot. Sound: café chatter, cups
clinking.
قبلة الزفاف.
The bride and groom stand under a flower arch outdoors, guests throw petals as
they kiss. Camera slowly rises from medium to wide shot. Sound: applause and
cheers.
قبلة مع حيوان أليف.
The woman from the reference photo hugs her golden retriever on a sunny lawn,
the dog licks her cheek and she laughs. Handheld camera at eye level. Sound:
birds, her laughter, a happy bark.
تنفّذ نماذج الفيديو الجمل المنطوقة والنصوص على الشاشة بدقة أقل من الأفعال. إذا احتجت إلى جملة، فاجعلها قصيرة وبالإنجليزية: لا تدعم Google رسميًا في Omni سوى الإنجليزية. وللصور الثنائية دون فيديو، راجع برومبت جلسة تصوير للأزواج.
أي الصور تصلح لفيديو قبلة بالذكاء الاصطناعي
- صور شخصية من الأمام أو بميلان خفيف مع ظهور العينين: يحافظ النموذج على الوجه أفضل حين يراه كاملًا.
- ضوء نهار متساوٍ بلا ظلال قاسية أو فلاتر ألوان.
- بلا نظارات شمسية أو كمامات أو أيدٍ قرب الوجه.
- وجه قريب: من الخصر إلى الأعلى أو أقرب. في اللقطة الواسعة يصغر الوجه ويضيع الشبه.
- ملابس الصورة هي ملابس المقطع ما لم تصف غيرها. في اختبارنا انتقلت السترة والقميص إلى المشاهد الثلاثة.
- في صورة الثنائي، يظهر الوجهان ولا يغطي أحدهما الآخر.
الحدود والأخلاقيات
- المدة. يصل توليد Gemini Omni الواحد إلى 10 ثوانٍ. وتُركَّب القصة الأطول من عدة مقاطع.
- الحركات المعقدة. الرقصات السريعة والرفعات والأذرع المتشابكة تُنتج عيوبًا أكثر من القبلة أو العناق الهادئ.
- الموافقة. استخدم صورتك وصورة شريك موافق. في روسيا تجيز المادة 152.1 من القانون المدني استخدام صورة الشخص بموافقته فقط، وقد تختلف قواعد بلدك. لا تصنع مقاطع مع شريك سابق أو زملاء عمل أو غرباء.
- الشخصيات العامة. لا تسمح Google برفع صور شخصيات عامة معروفة إلى Gemini Omni — مقطع «أنا أقبّل مشهورًا» سيُرفض.
- العلامة. تحمل مقاطع Gemini Omni علامة مائية خفية هي SynthID.
الخلاصة
يعطي فيديو القبلة بالذكاء الاصطناعي أفضل نتيجة من صورتين شخصيتين واضحتين وبرومبت خاص بك: تتحكم في المكان والحركة والصوت، وتبقى الوجوه معروفة. إذا كانت لديك صورة تجمعكما، فاجعلها الإطار الأول ويبدأ المقطع من لقطتك. تأثيرات القوالب في التطبيقات أسرع، لكنها تعطي الجميع المشهد نفسه. وللهدية في ذكرى سنوية، أو تهنئة عن بُعد، أو مقطع لثنائي من مؤثري الذكاء الاصطناعي، استخدم نموذج فيديو بالمراجع. تُصنع القبلة والعناق والرقصة في مولّد AI2Face: تظهر التكلفة قبل كل تشغيل، ويمكنك الدفع بالبطاقة أو بالعملات المشفرة، ولا تنتهي صلاحية أرصدة الباقات. ولإحياء صورة واحدة فقط، راجع دليل تحريك صورة.
الأسئلة الشائعة
كيف أصنع فيديو قبلة بالذكاء الاصطناعي من صورة؟
ارفع صورتين شخصيتين أو صورة واحدة للثنائي إلى نموذج فيديو يقبل المراجع، مثل Gemini Omni، وصِف المشهد: أين يقف الثنائي، وكيف يقتربان ويتبادلان القبلة، وكيف تتحرك الكاميرا. وخلال دقيقة تقريبًا تحصل على مقطع بصوت.
هل يمكن صنع قبلة من صورتين مختلفتين؟
نعم. أرفق الصورتين كمرجعين واذكر في البرومبت من يأتي من أي صورة. في اختبارنا بقيت الوجوه من لقطتين منفصلتين ثابتة في القبلة وفي العناق.
هل يمكن صنع فيديو قبلة بالذكاء الاصطناعي مجانًا؟
نعم، للتجربة. يمنحك AI2Face أرصدة ترحيبية بعد التسجيل — تكفي لمقطع قصير. تظهر التكلفة قبل البدء، ولا تضيف الخدمة علامة مائية على النتيجة.
ما أنسب الصور لفيديو قبلة بالذكاء الاصطناعي؟
صور شخصية واضحة من الأمام في ضوء النهار، دون نظارات شمسية أو كمامات أو فلاتر قوية. ينبغي أن يشغل الوجه جزءًا معتبرًا من الإطار.
هل يمكن صنع عناق أو رقصة بالطريقة نفسها؟
نعم، يتغير وصف الحدث فقط. صنعنا عناق اللقاء من الصورتين الشخصيتين نفسيهما، والرقصة البطيئة من صورة واحدة للثنائي في مطبخ.
المصادر
4
- https://ai.google.dev/gemini-api/docs/omni
- https://blog.google/innovation-and-ai/technology/developers-tools/build-with-gemini-omni-1-1-flash/
- https://blog.google/innovation-and-ai/products/nano-banana-pro/
- https://www.consultant.ru/document/cons_doc_LAW_5142/14c6c3902cffa17ab26d330b2fd4fae28e5cd059/